À la fin de notre décryptage d'AX et d'Agent Substrate, une question restait en suspens : où partent les appels au LLM de ces millions d'agents ? Aujourd'hui, la réponse tient en un mot : chez Gemini, hors du cluster. On dispose d'une plateforme autonome pour exécuter les agents, mais leur « cerveau » est loué à l'extérieur. Le Gateway API Inference Extension, un projet de la communauté Kubernetes, permet de rapatrier l'autre moitié : héberger les modèles dans le même cluster, en envoyant chaque requête vers le serveur le mieux placé pour y répondre. Agents et modèles sous le même toit, c'est la condition d'une plateforme IA souveraine. Il reste un verrou, et il ne se trouve pas du côté de Kubernetes.
Des agents dans le cluster, un cerveau au-dehors
Reprenons le restaurant de notre premier article. Grâce à Agent Substrate, la salle tourne enfin rond : un client n'occupe une table que lorsqu'il mange, et la place est rendue dès qu'il part se promener. Seulement voilà, ce restaurant n'a pas de cuisine. Chaque commande part vers une cuisine centrale à l'autre bout de la ville, et revient livrée. Les recettes sortent de la maison, la carte et les prix sont fixés ailleurs, et chaque plat se paie à la livraison.
C'est, à peu de chose près, la situation d'AX. Ses propres composants ne savent parler qu'à Gemini : la ressource Model, mais aussi l'agent qui prépare un espace de travail à partir d'un objectif en langage naturel. La sandbox réclame même une clé GEMINI_API_KEY pour s'initialiser, comme le détaille une issue ouverte par un contributeur. Le code de l'agent, lui, s'exécute dans l'image de son choix et peut appeler un autre fournisseur, à condition que la Gateway d'AX l'autorise. Mais par défaut, le cerveau est dehors.
Pourquoi vouloir le rapatrier ? Pour au moins quatre raisons :
- Les données. Les prompts, le code des dépôts clonés dans l'espace de travail, les résultats des outils : tout transite par le fournisseur. C'est l'argument central de Pourquoi créer sa propre plateforme GenAI ?.
- La dépendance. Un seul fournisseur, c'est ses tarifs, ses quotas et son calendrier de mise à jour des modèles. Les modèles à poids ouverts rendent l'alternative crédible, comme le montre l'arrivée de GLM-5.2, qui rattrape les modèles fermés.
- Le coût à l'échelle. Des milliers d'agents qui renvoient des contextes de plus en plus longs, c'est une facture au token qui grimpe vite. Les tokens sont devenus l'or noir de l'IA.
- La cohérence. AX verrouille soigneusement les sorties réseau de chaque agent. Fermer les portes de la salle n'a pas beaucoup de sens si chaque commande doit sortir.
Une nuance s'impose toutefois entre « autonome » et « souverain ». L'architecture garantit l'autonomie : Agent Substrate n'est pas lié à GKE, il s'installe sur un simple cluster local kind, et il s'appuie sur un stockage objet standard. La souveraineté, elle, dépend aussi des modèles choisis et de l'endroit où est hébergé le cluster. C'est un débat plus large, que nous avons déjà ouvert à l'échelle européenne avec l'émancipation de l'infrastructure IA.
Héberger un LLM dans Kubernetes : pourquoi un Service ne suffit pas
Exécuter un modèle sur sa propre machine n'a plus rien d'exotique : un premier LLM se lance en cinq minutes avec Ollama. Dans un cluster, on passe à l'échelle supérieure : plusieurs pods d'un serveur de modèles comme vLLM, sur des nœuds équipés de GPU, derrière un Service Kubernetes. Et c'est là que le bât blesse.
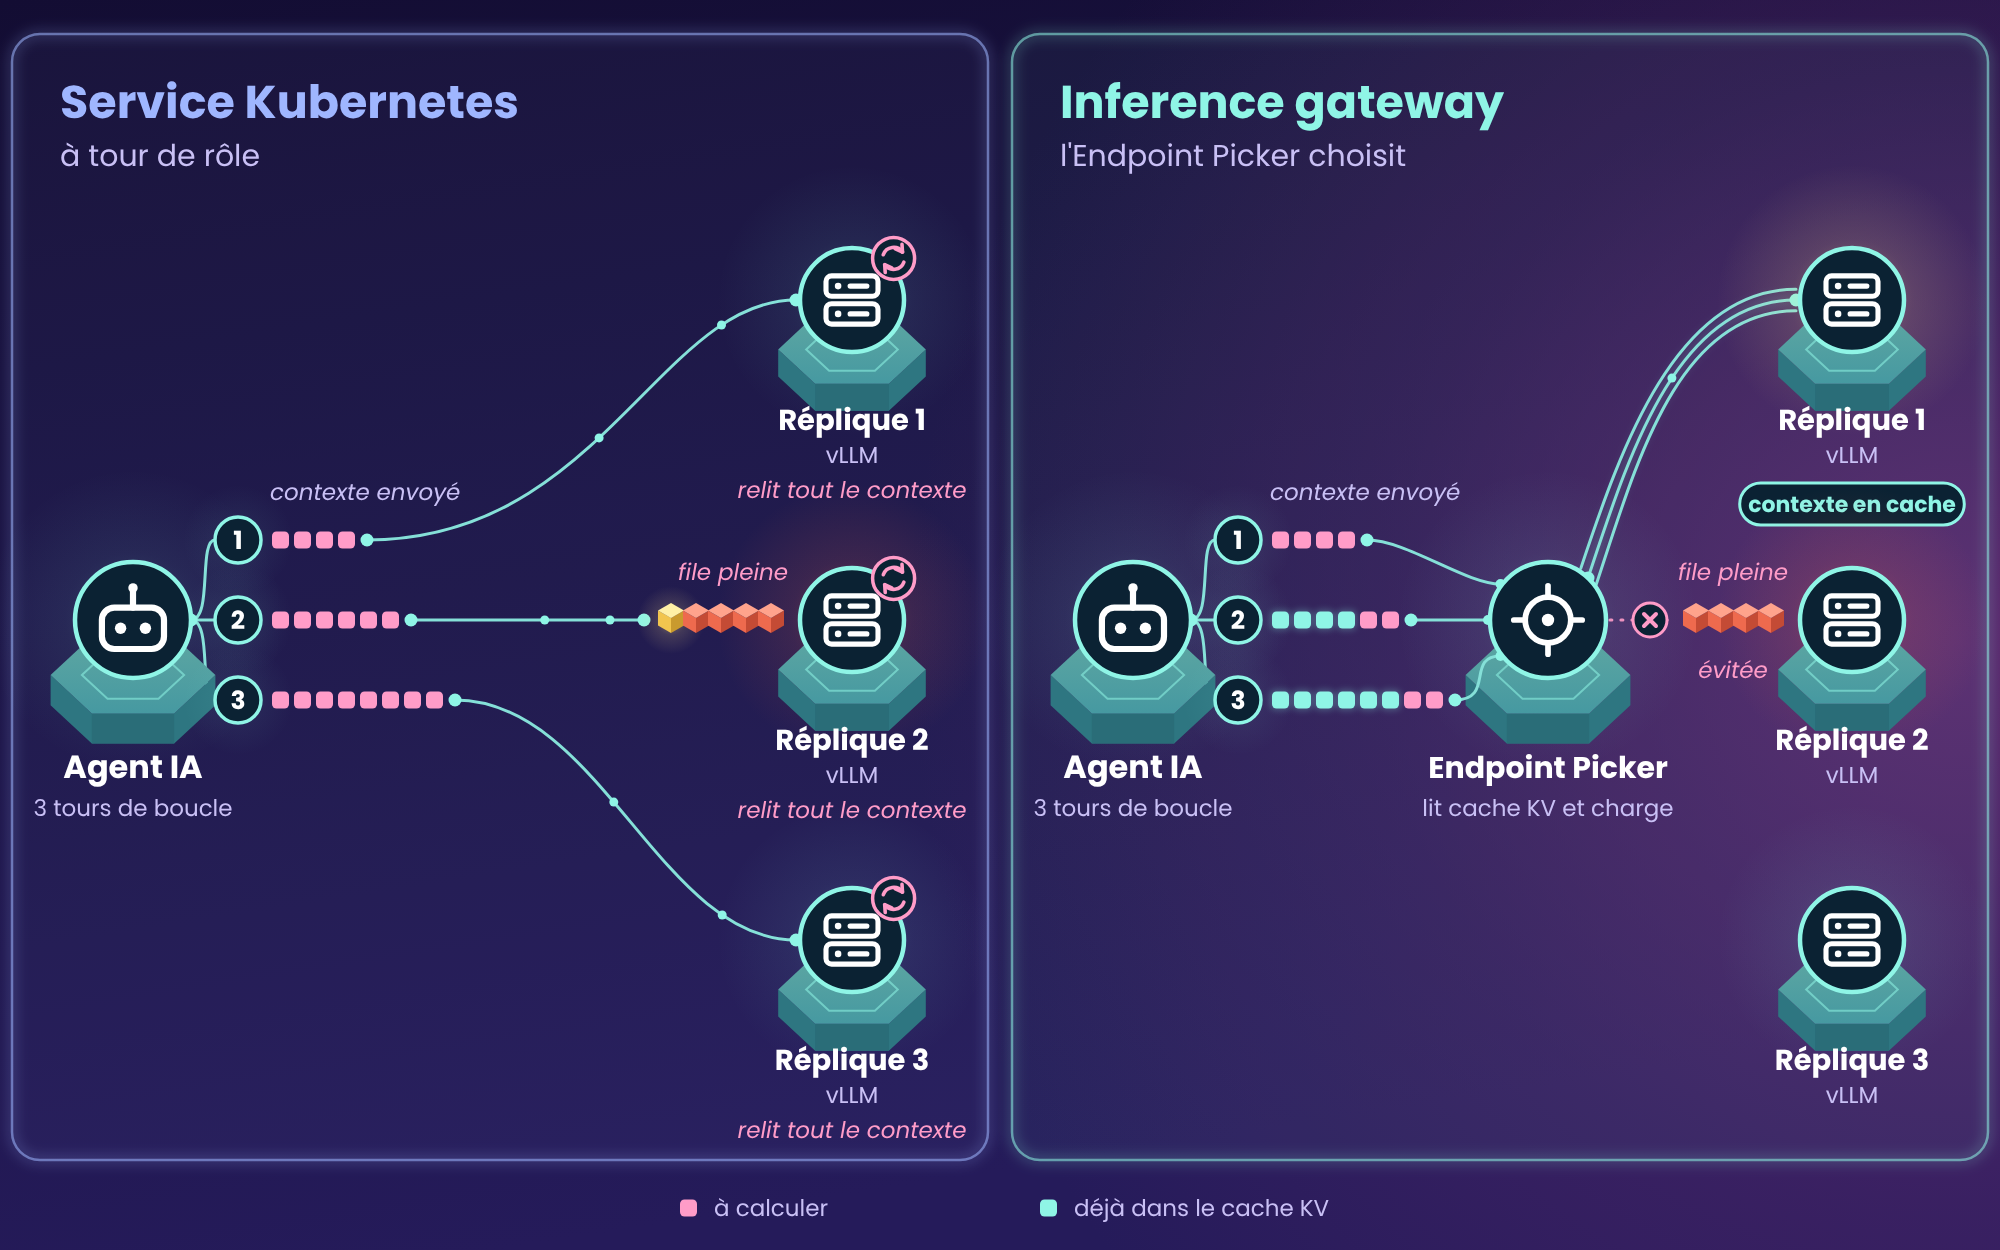
Un Service répartit les requêtes à tour de rôle, ou presque au hasard, entre les pods. C'est parfait pour des requêtes courtes et toutes semblables, comme celles d'une API classique. Une requête LLM ne leur ressemble pas : son coût varie énormément selon la longueur du prompt et de la réponse, et surtout, son traitement dépend de l'état du serveur qui la reçoit.
- Le cache KV. Avant de générer le moindre mot, le serveur doit « lire » tout le prompt, un calcul qui grossit avec la longueur du contexte. Le résultat est conservé en mémoire GPU, dans le cache KV. Si la requête suivante commence de la même façon, le serveur reprend ce calcul au lieu de le refaire.
- La file d'attente. Une réplique peut être saturée pendant que sa voisine reste les bras croisés.
- Les adaptateurs LoRA. Ces petites couches de spécialisation greffées sur un modèle de base ne sont pas forcément chargées partout.
Pour des agents, le premier point est décisif. À chaque tour de boucle, un agent renvoie son prompt système, la liste de ses outils et un historique qui s'allonge. Tomber sur la réplique qui a déjà ce contexte en cache évite de tout recalculer ; tomber sur une autre, c'est repartir de zéro. Chez un fournisseur, ce gaspillage est son problème, et il le facture en tokens. Dans votre cluster, chaque GPU mal utilisé se paie directement.
Retour en cuisine. Elle est rapatriée, mais comment répartir les commandes ? Le Service, c'est donner chaque bon au cuisinier suivant, à tour de rôle. Pourtant, l'un a déjà la sauce de ce client sur le feu, un autre croule sous les bons, un troisième a les ustensiles de la spécialité demandée. Dans une brigade, celui qui annonce les bons et les attribue a un nom : l'aboyeur. C'est exactement le rôle que le Gateway API Inference Extension ajoute à Kubernetes.
Gateway API Inference Extension : la gateway qui sait choisir son GPU
Pour exposer des applications, Kubernetes a longtemps reposé sur l'Ingress. Son successeur, la Gateway API, décrit plus finement les points d'entrée et les routes. Le Gateway API Inference Extension (GIE) s'appuie sur elle : il transforme n'importe quelle gateway compatible en « inference gateway », à condition qu'elle sache consulter un service externe à chaque requête. C'est le rôle d'ext_proc, un mécanisme d'Envoy repris par de nombreuses gateways.
L'objet central s'appelle InferencePool. Il désigne un groupe de serveurs de modèles, et le composant qui choisira parmi eux : l'Endpoint Picker (EPP), notre aboyeur. Dans une route, on le met simplement à la place du Service :
apiVersion: inference.networking.k8s.io/v1
kind: InferencePool
metadata:
  name: vllm-qwen3-32b
spec:
  selector:
    matchLabels:
      app: vllm-qwen3-32b
  targetPorts:
    - number: 8000
  endpointPickerRef:
    name: vllm-qwen3-32b-epp
    port:
      number: 9002
---
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: llm-route
spec:
  parentRefs:
    - name: inference-gateway
  rules:
    - backendRefs:
        - group: inference.networking.k8s.io
          kind: InferencePool
          name: vllm-qwen3-32b
Attention à ne pas confondre avec une « AI gateway » comme LiteLLM, qui fédère plusieurs fournisseurs de modèles derrière une même API. GIE travaille un cran plus bas : il route vers vos propres serveurs, à l'intérieur du cluster.
Le trajet d'une requête
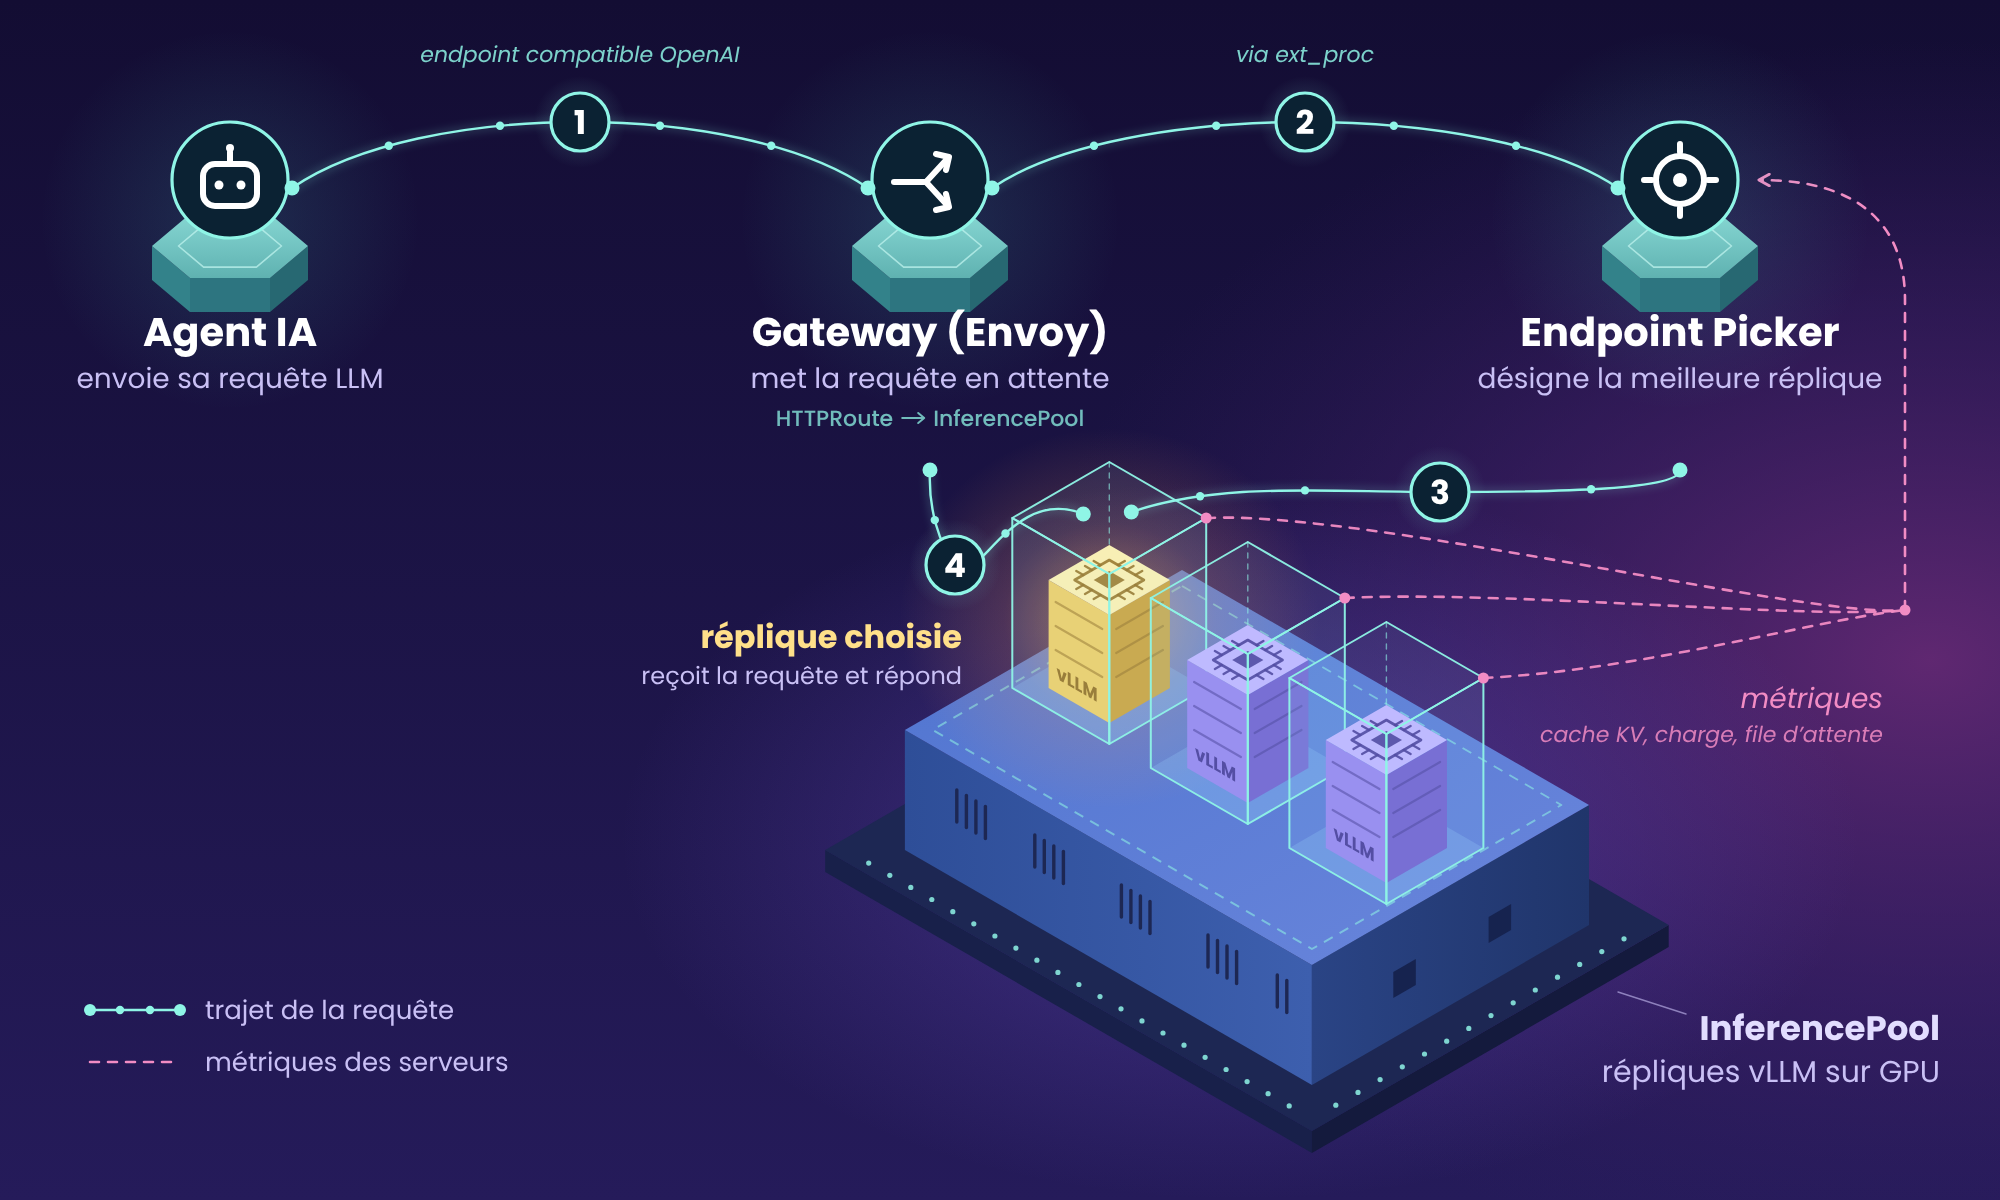
- L'agent appelle l'endpoint de la gateway, compatible avec l'API d'OpenAI.
- La gateway met la requête en attente et consulte l'Endpoint Picker via
ext_proc. - L'EPP s'appuie sur les métriques des serveurs pour désigner la meilleure réplique.
- La gateway transmet la requête à cette réplique, qui répond directement.
Ce que regarde l'Endpoint Picker
L'EPP pèse plusieurs critères : la présence du contexte dans le cache KV, la charge de chaque réplique et la priorité de la requête. Deux ressources complètent le tableau. InferenceObjective permet de servir d'abord les requêtes interactives et de faire patienter les traitements de fond. InferenceModelRewrite réécrit le nom du modèle demandé côté réseau, ce qui permet de basculer progressivement le trafic vers une nouvelle version, sans toucher au code des clients.
Un standard ouvert, plusieurs implémentations
GIE est un projet de la communauté Kubernetes, sorti en version stable, avec des tests de conformité que chaque implémentation doit passer. La documentation en recense plusieurs, dont Istio, NGINX Gateway Fabric, agentgateway ou Higress, et le projet cite aussi Envoy Gateway, kgateway et la Gateway de GKE. Pour une plateforme qui vise la souveraineté, c'est un argument de poids : on ne dépend d'aucun éditeur. Le sujet a d'ailleurs fait partie des temps forts de la KubeCon 2026, aux côtés de vLLM et de llm-d.
Un détail qui a son importance si vous suivez un tutoriel : depuis la version 1.6, le dépôt de GIE ne contient plus que le standard, c'est-à-dire l'API InferencePool, le protocole de l'EPP, un EPP minimal de référence et les tests de conformité. L'Endpoint Picker complet, InferenceObjective et InferenceModelRewrite vivent désormais dans le projet llm-d-router. Les guides antérieurs à ce découpage pointent donc parfois vers du code qui a déménagé.
Le même geste qu'Agent Substrate
Les lecteurs de notre premier article auront reconnu le motif. Agent Substrate place un routeur Envoy devant les agents : à chaque requête, il demande à son API « où est cet agent ? réveille-le », puis transmet la requête au bon worker. Le Gateway API Inference Extension place une gateway devant les modèles : à chaque requête, elle demande à l'Endpoint Picker « quelle réplique est la mieux placée ? », puis transmet la requête au bon GPU.
Dans les deux cas, la décision de routage est retirée au Service Kubernetes et confiée à un composant spécialisé, branché sur Envoy et qui tranche à la milliseconde. Dans les deux cas, Kubernetes garde ce qu'il fait le mieux : fournir les machines, placer les pods et ajuster leur nombre. Il reste le socle des deux moitiés de la plateforme.
Agents et modèles sous le même toit
Assemblons les pièces. Les agents occupent des workers Agent Substrate, sur un pool de nœuds CPU. Leurs appels au LLM passent par l'inference gateway, qui les répartit entre des serveurs de modèles, sur un pool de nœuds GPU. Et rien ne sort du cluster.
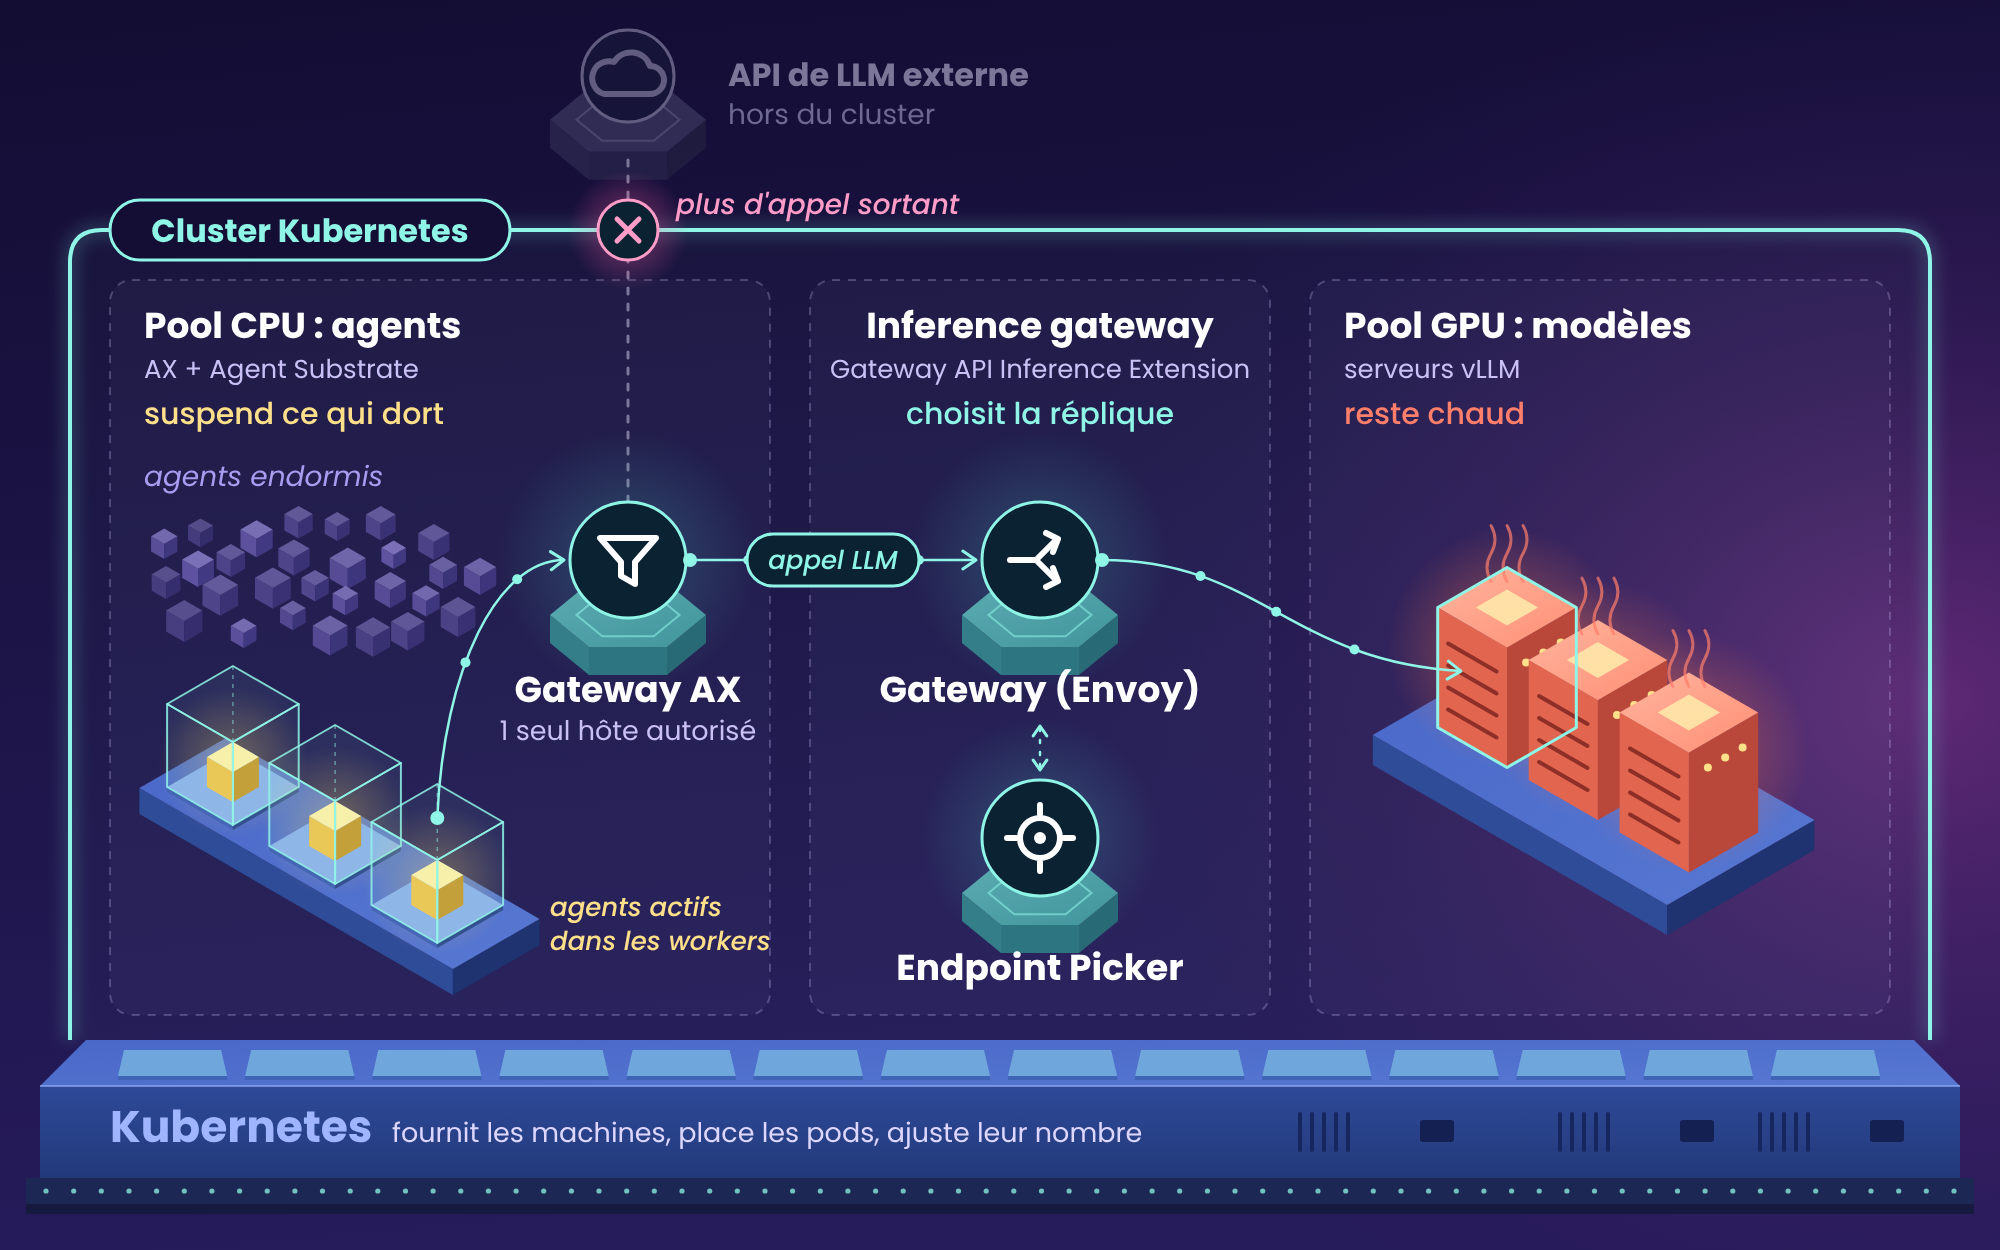
Le verrou réseau d'AX prend alors tout son sens. Une Gateway AX dont la liste blanche ne contient qu'un seul hôte, l'inference gateway interne, garantit que les agents n'appellent jamais l'extérieur. Et quand des milliers d'agents se réveillent par rafales, InferenceObjective permet de servir d'abord ceux qui ont un humain en face, ce qu'aucune des deux briques de l'article 1 ne sait exprimer.
Les deux moitiés obéissent pourtant à des économies opposées. Côté agents, on gagne en suspendant tout ce qui dort. Côté modèles, il faut au contraire rester chaud : redémarrer un serveur, c'est recharger des dizaines de gigaoctets de poids en mémoire GPU. Pour filer la métaphore une dernière fois, la salle se remplit et se vide au rythme des clients, mais les fourneaux restent allumés toute la journée. Deux métiers, deux pools de nœuds, sur les mêmes fondations.
Et la souveraineté a un prix, qu'il faut regarder en face : des GPU à acheter ou à louer, des modèles à poids ouverts à choisir, évaluer et mettre à jour, et une brique de plus à exploiter, avec ses propres métriques et ses propres pannes.
Le dernier verrou : AX ne parle qu'à Gemini
Tout cela fonctionne déjà pour le code des agents : dans sa propre image, un agent peut appeler l'endpoint de l'inference gateway, dès lors que la Gateway d'AX l'autorise. En revanche, AX lui-même ne suit pas encore. Sa ressource Model et la préparation des espaces de travail restent liées à Gemini, et la sandbox réclame une clé Gemini au démarrage.
L'issue #375 propose une sortie simple : un fournisseur openai, avec une baseURL qui pointerait vers un serveur vLLM interne. Le contributeur a testé ses modifications de bout en bout sur un cluster local, mais le dépôt n'accepte pas de contributions externes pour l'instant, et aucun mainteneur n'y a encore répondu. Tant que ce point n'est pas traité, la plateforme n'est autonome qu'à moitié.
Une plateforme IA souveraine, à quel prix ?
Le constat est encourageant : agents et modèles peuvent désormais vivre dans le même Kubernetes, avec, à chaque étage, le même geste architectural. On garde Kubernetes comme socle, et on lui adjoint un composant spécialisé qui décide à la milliseconde. Pour l'exécution des agents, c'est Agent Substrate. Pour leurs appels au LLM, c'est le Gateway API Inference Extension, un standard ouvert, stable et déjà implémenté par plusieurs gateways.
Faut-il pour autant tout rapatrier ? Pas forcément. L'approche se justifie pour les équipes qui ont une vraie contrainte de confidentialité ou de dépendance, et le volume pour amortir des GPU. Pour les autres, un fournisseur externe reste plus simple, au moins le temps qu'AX apprenne à parler à autre chose qu'à Gemini. Côté données, certains ont déjà fait le chemin : ce retour d'expérience sur une data stack souveraine en donne un aperçu.
Le maillon manquant n'est donc plus du côté de Kubernetes, mais du côté d'AX. Le jour où il saura viser un modèle interne, il ne restera qu'à brancher les deux bouts : un bon sujet pour un prochain article.