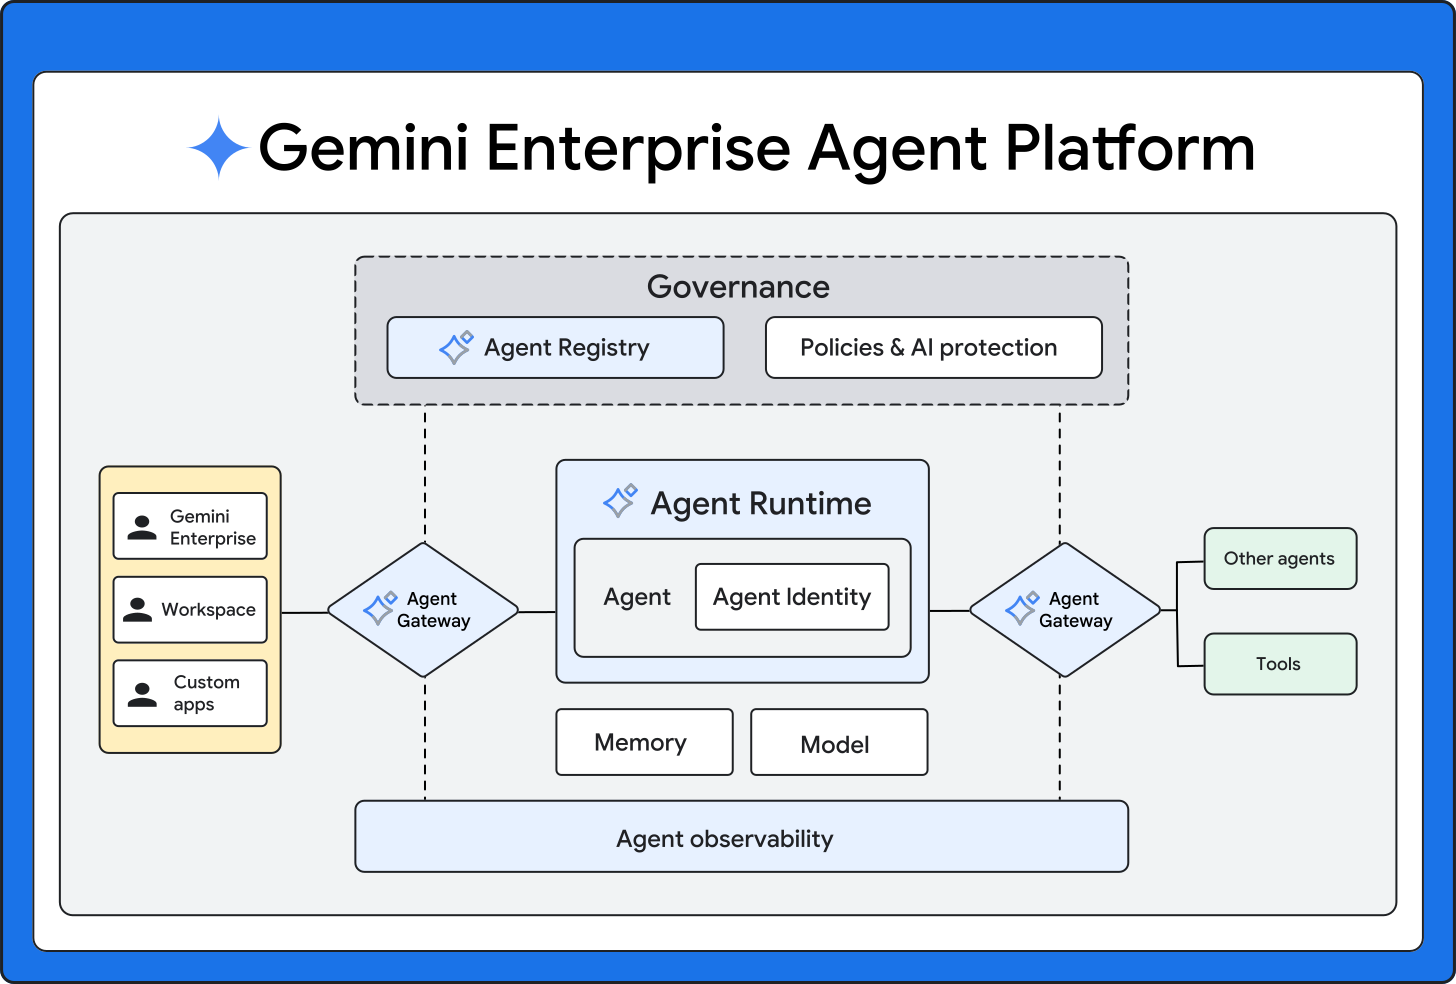
Google a regroupé sous le nom Gemini Enterprise Agent Platform ce qui était auparavant dispersé dans Vertex AI : le framework de développement, le runtime, l'identité, le réseau et l'observabilité des agents. La plateforme s'organise en quatre étapes : construire, mettre à l'échelle, gouverner, optimiser. Elle est distincte de l'application Gemini Enterprise, par laquelle les agents sont mis à disposition des employés : la plateforme est ce sur quoi on les construit et on les exploite.
Elle répond aux questions habituelles d'une mise en production : qui appelle quoi, avec quelle identité, à travers quel point de contrôle, avec quelles mesures de protection, et où atterrissent les traces.
ADK
Google ADK (Agent Development Kit) est un framework disponible en Python, TypeScript, Go, Java et Kotlin. Il couvre la définition des agents, l'écosystème d'outils, l'orchestration (pipelines déterministes ou routage dynamique), les systèmes multi-agents et l'évaluation. Un agent ADK tourne en local ou se déploie sur Agent Runtime, Cloud Run ou GKE.
Pour ceux qui préfèrent partir d'un existant ou d'une interface visuelle, Agent Garden propose des agents prêts à l'emploi et Agent Studio offre une interface low-code pour dessiner des boucles de raisonnement multi-agents.
Agent Runtime
C'est l'environnement d'exécution managé. Le déploiement se fait depuis des fichiers sources, un Dockerfile ou une image de conteneur. L'agent déployé est exposé comme une ressource reasoningEngine sur l'API régionale LOCATION-aiplatform.googleapis.com, authentifiée et autorisée via Google IAM. Les paramètres de mise à l'échelle (nombre minimal et maximal d'instances, CPU, mémoire) se règlent au déploiement.
Côté Terraform, la ressource est google_vertex_ai_reasoning_engine :
resource "google_vertex_ai_reasoning_engine" "agent" {
  display_name = "support-agent"
  region       = "europe-west1"

  spec {
    source_code_spec { /* inline_source, python_spec, image_spec... */ }

    deployment_spec {
      min_instances = 1
      max_instances = 10
      env {
        name  = "GOOGLE_CLOUD_AGENT_ENGINE_ENABLE_TELEMETRY"
        value = "true"
      }
    }

    class_methods = jsonencode([/* ... */])
  }
}
class_methods doit être renseigné à la main (liste JSON des méthodes de l'agent, différente selon le framework). Sans lui, les clients du SDK ne découvrent pas les méthodes exposées.
Sessions et Memory Bank
Deux services d'état séparés du code de l'agent. Les Sessions conservent les conversations multi-tours, avec des identifiants de session personnalisables. Le Memory Bank ingère les événements, génère des profils de mémoire et restitue le contexte pertinent au moment de l'exécution. Le conteneur reste sans état et peut redémarrer sans perdre le fil.
Model Garden
Le catalogue de modèles : modèles Google (Gemini, Veo, Lyria), modèles partenaires (p. ex. Claude, Mistral, Grok) et modèles ouverts (p. ex. DeepSeek, Llama, Qwen) en Model-as-a-Service ou auto-déployés.
Agent Identity
C'est la brique qui change le plus les habitudes. Chaque agent déployé reçoit une identité SPIFFE et un certificat X.509. Le certificat est valable 24 heures et Google Cloud le renouvelle automatiquement. Les jetons d'accès sont liés cryptographiquement au certificat de l'agent, ce qui limite le vol de jeton : un jeton capturé ne se rejoue pas en dehors de l'environnement d'exécution de l'agent.
Comparé à un compte de service : une identité d'agent n'est pas partagée entre plusieurs charges de travail, ne peut pas être usurpée par impersonation, et n'autorise pas la génération de clés à longue durée de vie. L'agent peut s'authentifier en son nom propre ou pour le compte de l'utilisateur final, et les accès restent attribuables à son SPIFFE ID.
Il n'y a pas de ressource Terraform dédiée : l'identité s'active sur le reasoning_engine avec identity_type = "AGENT_IDENTITY" (le champ service_account doit alors rester vide).
resource "google_vertex_ai_reasoning_engine" "agent" {
  display_name = "support-agent"
  region       = "europe-west1"

  spec {
    identity_type = "AGENT_IDENTITY"
    # ...
  }
}

resource "google_storage_bucket_iam_member" "agent_reader" {
  bucket = google_storage_bucket.data.name
  role   = "roles/storage.objectViewer"
  member = google_vertex_ai_reasoning_engine.agent.spec[0].effective_identity
}
Avec un compte de service classique, l'identité, ses droits et l'objet de calcul sont trois ressources indépendantes : on crée le compte, on lui accorde ses rôles, puis on le branche sur le service. Ici, l'identité est dérivée de l'identifiant de la ressource, elle n'existe qu'une fois le reasoning_engine créé.
Agent Gateway
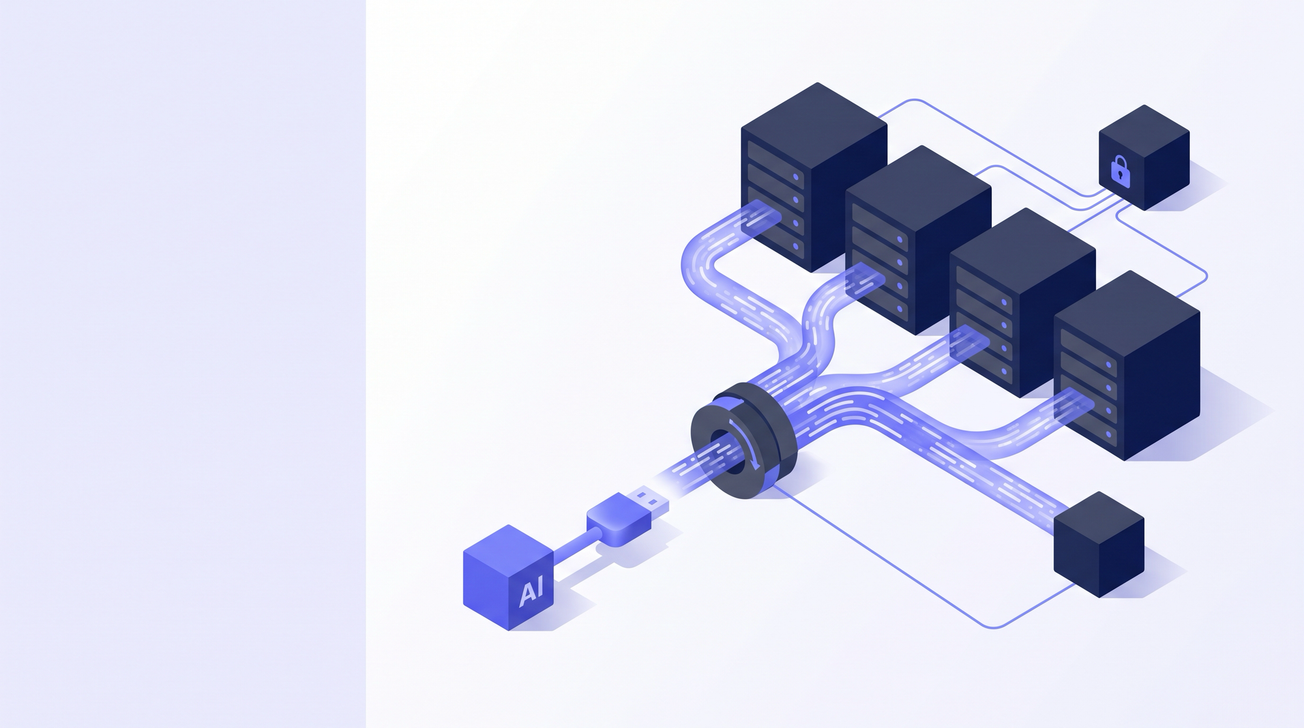
Le point d'entrée et de sortie réseau de toutes les interactions d'agents. Il y a deux modes :
- Client-to-Agent (ingress) : contrôle quels clients atteignent quels agents et quelles politiques s'appliquent.
- Agent-to-Anywhere (egress) : contrôle les appels sortants vers les serveurs MCP, les API tierces et les autres agents.
L'autorisation passe par des politiques IAM appuyées sur le SPIFFE ID de l'agent, par des politiques de gouvernance sémantique en langage naturel, et par des Service Extensions pour brancher un moteur d'autorisation maison. La passerelle gère tout le trafic HTTP, y compris MCP et A2A, et sait analyser les requêtes MCP pour une autorisation fine, par exemple restreindre l'accès à certains outils d'un serveur.
Pour sortir vers un réseau privé, la passerelle s'appuie sur un Private Service Connect network attachment, une ressource du VPC cible. Le trafic sortant des agents entre dans ce VPC par cette interface PSC et prend les adresses du sous-réseau associé, ce qui laisse écrire des règles de pare-feu sur une source stable. Les règles VPC Service Controls s'appliquent alors au trafic des agents, et avec le peering Cloud DNS, les agents résolvent les zones privées du VPC cible.
En Shared VPC, le network attachment se crée dans le projet de service, ce que la documentation recommande, ou dans le projet hôte. Le trafic suit alors le routage déjà en place, ce qui permet de rattacher les agents à une topologie hub and spoke existante.
Côté Terraform, la ressource est google_network_services_agent_gateway. Le mode se choisit dans le bloc google_managed :
resource "google_network_services_agent_gateway" "egress" {
  name     = "agents-egress"
  location = "europe-west1"

  google_managed {
    governed_access_path = "AGENT_TO_ANYWHERE"
  }
}
Model Armor
Le filtre de contenu, branché sur la passerelle dans les deux sens. Il inspecte les prompts et les réponses : injection de prompt et jailbreak, contenus sensibles au titre de l'IA responsable, données personnelles ou secrets via Sensitive Data Protection, URL malveillantes. La configuration se fait par templates (des jeux de filtres avec un seuil de confiance), avec des floor settings pour imposer un socle commun. Deux modes d'application : inspection seule, ou inspection et blocage.
Les deux objets ont leur ressource Terraform : google_model_armor_template, et google_model_armor_floorsetting, rattaché à une organisation, un dossier ou un projet :
resource "google_model_armor_template" "prompts" {
  location    = "europe-west1"
  template_id = "agent-prompts"

  filter_config {
    pi_and_jailbreak_filter_settings {
      filter_enforcement = "ENABLED"
      confidence_level   = "MEDIUM_AND_ABOVE"
    }
    malicious_uri_filter_settings {
      filter_enforcement = "ENABLED"
    }
    sdp_settings {
      basic_config {
        filter_enforcement = "ENABLED"
      }
    }
  }
}

resource "google_model_armor_floorsetting" "org" {
  parent   = "organizations/${var.org_id}"
  location = "global"

  filter_config {
    pi_and_jailbreak_filter_settings {
      filter_enforcement = "ENABLED"
      confidence_level   = "HIGH"
    }
  }

  enable_floor_setting_enforcement = true
  ai_platform_floor_setting {
    inspect_and_block = true
  }
}
Agent Registry
Le catalogue centralisé des agents, outils, endpoints et serveurs MCP approuvés de l'organisation. Agent Gateway le consulte avant d'autoriser une connexion : ce qui n'est pas enregistré n'est pas joignable. On y déclare les agents (avec leur Agent Card A2A), les serveurs MCP (avec la liste de leurs outils) et les endpoints, à la main ou par import.
Observabilité
Les trois signaux sont managés par la stack Google Cloud Observability, sans rien à héberger : les métriques dans Cloud Monitoring, les logs dans Cloud Logging, les traces dans Cloud Trace.
Les métriques et les logs arrivent sans configuration. Agent Runtime remonte le nombre de requêtes, les latences et le temps d'allocation CPU et mémoire, avec un tableau de bord par défaut dans la console, et tout ce que l'agent écrit sur stdout et stderr part dans Cloud Logging. Les traces demandent une configuration via les variables d'environnement :
GOOGLE_CLOUD_AGENT_ENGINE_ENABLE_TELEMETRY: "true"
OTEL_SEMCONV_STABILITY_OPT_IN: "gen_ai_latest_experimental"
OTEL_INSTRUMENTATION_GENAI_CAPTURE_MESSAGE_CONTENT: "EVENT_ONLY"
Le trajet complet d'une requête
Le client appelle l'agent. Le trafic entre par Agent Gateway en mode ingress, qui valide l'identité du client et applique les politiques de la passerelle.
Model Armor inspecte le prompt entrant et bloque ou laisse passer selon le template.
Agent Runtime exécute l'agent. Les Sessions fournissent l'historique de conversation, le Memory Bank le contexte long terme.
L'appel au modèle part vers Model Garden. Le span correspondant apparaît dans la trace avec sa latence.
Si l'agent doit appeler un outil ou un serveur MCP, la sortie repasse par Agent Gateway en mode egress. L'appel est authentifié par le SPIFFE ID de l'agent, autorisé par les politiques IAM associées, inspecté par Model Armor, et routé vers le VPC selon le connectivity template.
La réponse remonte le même chemin. La trace complète arrive dans Cloud Trace, avec la latence de chaque appel.
Conclusion
La plupart des briques reprennent des objets déjà connus : un PaaS pour l'exécution, un proxy d'entrée et de sortie, une identité de charge de travail, un filtre de contenu, du tracing OpenTelemetry. Les réflexes d'exploitation transfèrent tels quels.
La différence tient au trafic sortant. Un service classique déclare ses dépendances dans le code, alors qu'un agent choisit ses appels d'outils pendant l'exécution, en fonction du contexte. Agent Gateway et Agent Identity pèsent donc plus lourd que le choix du framework : ce sont les deux endroits où cette sortie redevient énumérable et attribuable.