Une deep research découpe une question en sous-questions, fait chercher et lire les pages web par plusieurs agents, puis rédige un rapport sourcé à partir de leurs notes. Sur une deep research réelle, confier la recherche et la lecture des pages à des agents locaux, puis laisser Claude rédiger, fait passer la consommation de Claude d'environ 842k tokens à environ 195k, pour une qualité équivalente en relecture à l'aveugle : 32 sur 35, contre 33 quand tout tourne côté Claude. Tout confier au local fait tomber la note à 26 : la synthèse doit rester à Claude. Sur les petites délégations du quotidien (résumer un log, chercher une information), le principe tient aussi, mais le gain se compte en milliers de tokens : un log de 39 Ko coûte 965 tokens à Claude au lieu de 16 726.
Dans mon article précédent, j'ai fait passer six épreuves au modèle local : il réussissait le travail cadré et vérifiable (43 runs sur 45) et ratait plus d'une fois sur deux dès qu'il fallait du jugement. C'est moi qui lui passais chaque tâche. Ici, c'est Claude Code qui délègue, avec deux skills : ask-local pour les petites tâches et deep-research-local pour les recherches longues. L'installation ne change pas : Qwen3.8 27B sur une RTX 4090, avec Pi, le plus rapide des trois harnais testés. Les tokens sont mesurés avec la méthode de mon article sur la réduction des tokens.
Comment Claude Code délègue à un modèle local
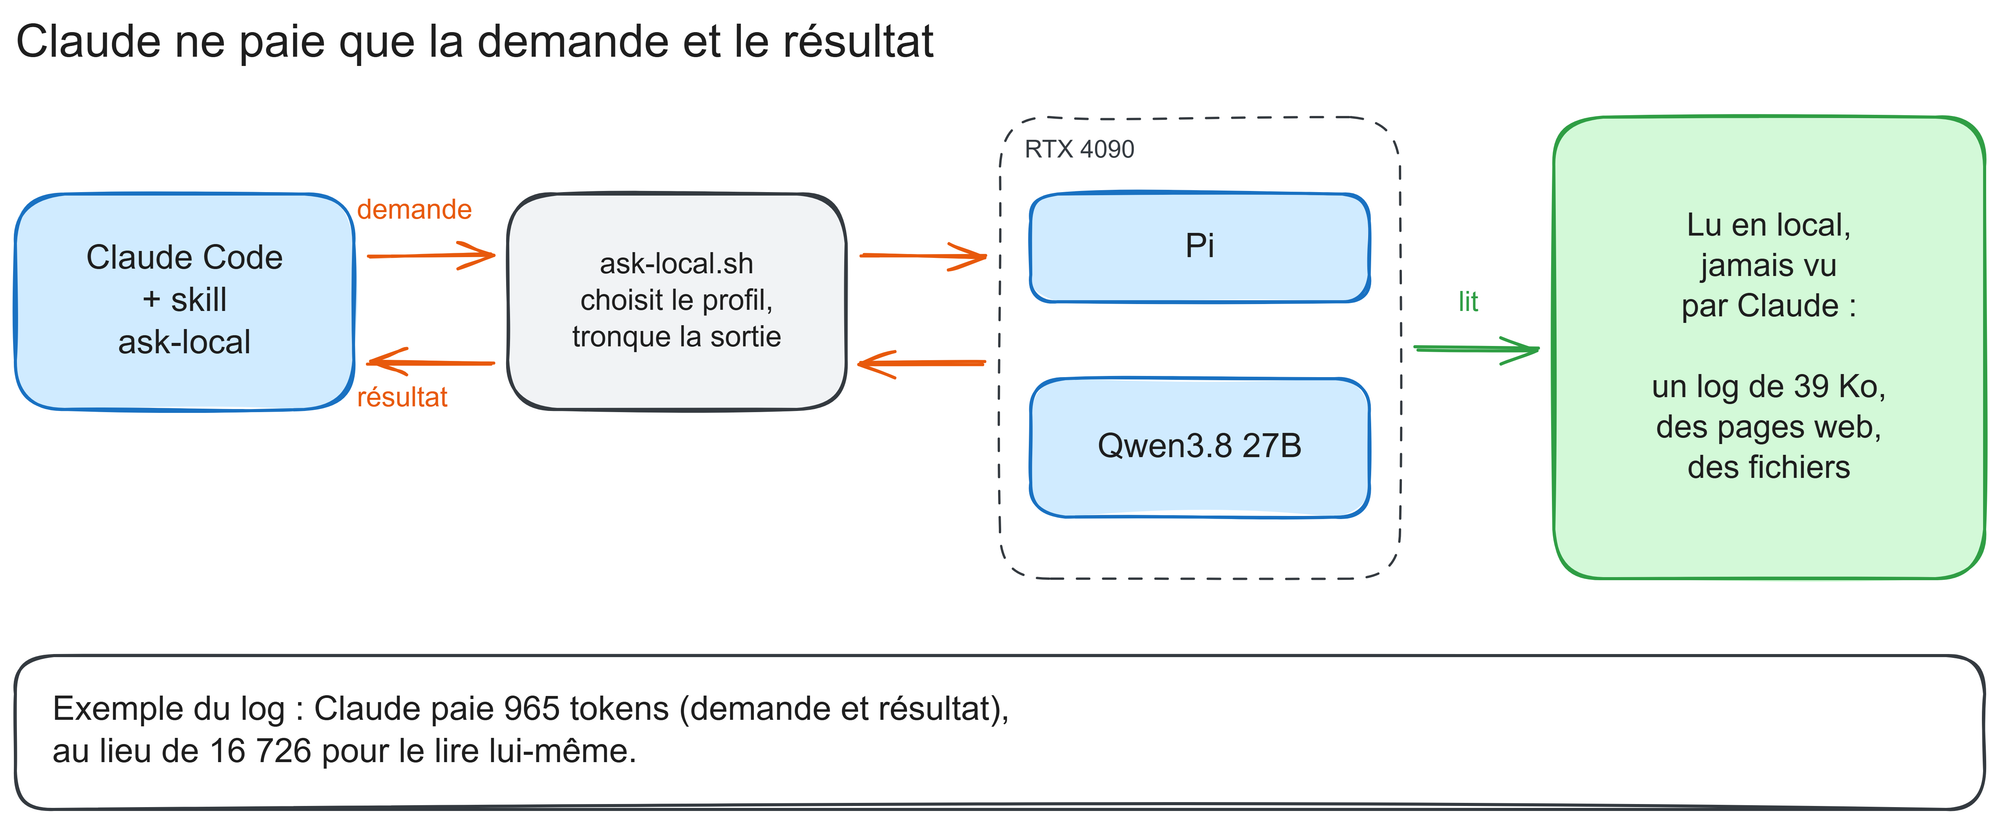
La délégation tient en deux pièces : un skill Claude Code, ask-local, et un script qui appelle Pi. Le skill dit à Claude quand déléguer et quel profil choisir ; le script lance Pi, attend la réponse et la met en forme. Claude ne voit que la ligne de commande et le résultat :
ask-local.sh --profile web "Quelle est la dernière release de llama.cpp ? Donne la source."Claude choisit un profil plutôt que des options à la main, et le script règle Pi en conséquence :
summarizepour résumer des fichiers ou des logs, sans accès au web ;webpour une recherche, avec un moteur de recherche local (SearXNG) branché en MCP ;codepour une tâche de code dans le repo, vérifiée par les tests.
Hors profil code, Pi tourne dans un dossier neutre : il lit les fichiers CLAUDE.md du dossier courant, et des consignes écrites pour Claude Code peuvent l'égarer. La sortie est tronquée avant de revenir à Claude, le texte complet reste dans un fichier.
J'ai choisi un skill plutôt qu'un serveur MCP : il coûte 148 tokens en permanence (son nom et sa description), puis environ 1 900 quand Claude le charge dans une session, et il se modifie plus vite. Dans les deux cas, le vrai coût reste la taille du résultat renvoyé.
Quand déléguer au modèle local, et quand garder la tâche
La règle écrite dans le skill : déléguer quand le modèle local va lire et écrire beaucoup plus que ce que Claude lira en retour, et quand le résultat se vérifie à bas coût. Une tâche qui lit 39 Ko de log pour rendre huit points passe ; une tâche dont Claude doit relire tout le résultat pour le vérifier ne fait rien gagner.
| Tâche | Pourquoi le gain | Comment vérifier |
|---|---|---|
| Résumer des logs, des sorties de tests | Gros fichier lu en local, résumé court | Survoler le passage cité |
| Recherche web | Pages entières lues en local | Ouvrir la source donnée |
| Tri, classement, extraction en masse | Répétitif, peu de jugement | Contrôler un échantillon |
Les mauvais candidats sont ceux de l'article précédent : un bug à diagnostiquer ou un ticket flou, que le local rate trop souvent et que Claude finit par refaire. S'y ajoutent les tâches urgentes : à environ 78 tokens par seconde, le local est plus lent que Claude.
La deep research précise la frontière. La recherche et la lecture des pages se délèguent bien ; la rédaction de la synthèse, non. Claude garde le découpage de la question, le croisement des sources et la rédaction.
C'est la répartition que j'applique déjà avec les sous-agents Claude : eux cherchent et lisent, le modèle principal synthétise. Le modèle local prend ce rôle de chercheur, et les pages qu'il lit ne passent plus par Claude.
Mesurer les tokens économisés avec count_tokens
Le premier chiffre que j'ai eu sous les yeux était trompeur. Le script relève les tokens traités par le modèle local à chaque requête. Sur un ticket de code délégué, le total atteint 466 000 tokens, cumulés sur 25 requêtes, pour 17 000 générés. Mais c'est la somme du contexte de chaque requête : Claude, avec son cache, relit l'historique à bas prix et n'aurait jamais payé 466 000 tokens pour la même tâche. Ce chiffre mesure le travail sorti de Claude, pas ce qu'on économise.
J'ai donc repris l'endpoint count_tokens de l'API Anthropic, gratuit, qui compte les tokens d'un texte avec le tokenizer de Claude. Pour chaque délégation :
- Évité : ce que Claude aurait dû lire lui-même ;
- Payé : la demande envoyée et le résultat relu par Claude ;
- Gain net : la différence. Un résultat que Claude doit refaire compte en perte.
count_tokens compte de l'input, et le quota d'un abonnement ne se lit pas en tokens bruts : je ne convertis pas ces chiffres en pourcentage de quota.
Pour la deep research, je compare au skill natif, avec des sous-agents Claude. Les tokens viennent du compteur que Claude Code affiche à la fin de chaque sous-agent : il inclut les lectures de cache, c'est un ordre de grandeur.
Les cas testés, du log à la deep research
Chaque délégation simple a été jouée une fois. Les colonnes Évité, Payé et Net sont comptées avec count_tokens, hors chargement du skill ask-local (environ 1 900 tokens, une fois par session).
| Cas | Durée | Retour lu par Claude | Évité | Payé | Net |
|---|---|---|---|---|---|
| Résumer un log de 39 Ko | 15 s | 8 points | 16 726 | 965 | +15 761 |
| Recherche web | 18 s | 2 lignes et une source | 841 | 462 | +379 |
Résumer un gros log : 39 Ko en huit points
Le log venait du banc d'essai de l'article précédent, 39 Ko de sortie d'un harnais. Le modèle local l'a lu en 15 secondes et en a tiré huit points, fidèles au log. Le lire aurait coûté 16 726 tokens à Claude ; il en a payé 965. C'est le cas le plus net : beaucoup de lecture, un retour court, une vérification rapide.
Recherche web : deux lignes et une source
La question : la dernière release de llama.cpp. En 18 secondes, le modèle local a lancé ses recherches, lu les pages et renvoyé deux lignes avec la source : la release du jour, juste. Claude n'a lu aucune page : la recherche a fonctionné sans lui, pour 462 tokens, la demande et la réponse. Côté local, la recherche a pris cinq appels au modèle et 27 672 tokens de contexte cumulés, un total qui ne se lit pas comme des tokens Claude évités (voir plus haut).
J'ai refait la même recherche avec Claude seul : une recherche, une page lue, 841 tokens dans son contexte. WebFetch ne lui rend qu'un extrait : un modèle secondaire, que la documentation ne nomme pas, lit la page dans un appel à part, jusqu'à 100 000 caractères. L'économie visible se limite à environ 380 tokens, plus cette lecture de la page, réelle mais que count_tokens ne mesure pas. Une recherche ponctuelle se délègue donc pour une économie légère ; le gain devient net quand il faut lire beaucoup de pages.
Deep research : déléguer la recherche, garder la rédaction
J'ai rejoué une deep research faite début octobre, une recherche sur un marché d'assets de jeu, avec les mêmes cinq sous-questions et la même consigne de rédaction. Trois versions :
- Natif : le skill de deep research de Claude Code, où des sous-agents Claude cherchent et rédigent ;
- Chercheurs locaux : Claude découpe la question, chaque sous-question part à un agent local qui cherche, lit les pages et rend des notes sourcées, une vérification passe sur les URL, puis Claude croise et rédige ;
- Tout local : le modèle local rédige aussi la synthèse.
Un agent Claude a relu les trois rapports sans savoir lequel était lequel. Il les a notés sur 5 selon sept critères : couverture du sujet, précision des chiffres, qualité des sources, plan d'action exploitable, distinction entre limites strictes et simples recommandations, honnêteté sur ce qui reste à vérifier, exactitude. Il a aussi vérifié sur le web quatre affirmations de chacun.
| Natif | Chercheurs locaux | Tout local | |
|---|---|---|---|
| Tokens Claude | ~842k | ~195k (−77 %) | 0 |
| Durée | ~14 min | ~31 min | ~30 min |
| Note à l'aveugle | 33/35 | 32/35 | 26/35 |
| Sources | ~90, beaucoup primaires | ~45, surtout primaires | ~60, dont beaucoup hors sujet |
| Erreurs relevées | Dates incohérentes, état ancien du sujet | 1 citation mal attribuée | Citation inventée, contradiction non vue |
Avec les chercheurs locaux, Claude consomme environ un quart des tokens du natif pour une qualité équivalente : un point d'écart sur 35, avec un seul relecteur, n'est pas une différence. Le relecteur n'y a trouvé qu'une erreur, une citation mal attribuée. Les agents locaux trouvent moins de sources primaires, mais celles qu'ils gardent sont pertinentes. En tout local, c'est la rigueur qui baisse : une citation inventée, une contradiction entre deux sources passée inaperçue. La portée reste limitée : un seul sujet, un seul run par version, et un relecteur qui est lui-même un modèle.
Depuis, j'ai lancé huit autres deep research avec les chercheurs locaux, sur du modding de jeu vidéo et du game design. Côté Claude, il ne reste que le rédacteur : 106k tokens en médiane par recherche. Sur mes deux deep research natives, un chercheur Claude coûte 104k tokens en médiane et le rédacteur de 152k à 188k. À nombre de sous-questions égal, les neuf recherches auraient coûté environ 4,7 millions de tokens en natif, contre 1,1 million : −76 %, une estimation cohérente avec le sujet rejoué.
Sur ces neuf recherches, 3 appels de chercheurs locaux sur 32 n'ont rien rendu et ont été relancés, et 10 URL sur 721 ne répondent pas. Une URL qui répond ne prouve pas que la page dit ce que la note affirme : c'est à Claude de le vérifier en rédigeant.
Ce que la délégation coûte en dehors des tokens
Le temps d'abord. Les délégations simples prennent de 15 à 18 secondes. La deep research prend plus du double du natif, environ 31 minutes contre 14 : avec un seul GPU, les agents locaux passent l'un après l'autre, là où les sous-agents Claude travaillent en parallèle.
Pendant ces 31 minutes, Claude Code n'affiche rien. J'ai écrit un mod Claude Code qui affiche au-dessus du prompt le chercheur en cours, le nombre de chercheurs terminés et la durée. Une commande du même mod ouvre aussi un panneau qui suit en direct le transcript du modèle local. Le mod lit des fichiers d'état écrits par les scripts, sans coût en tokens pour Claude.
Ensuite, la friction :
- Un sous-agent Claude Code ne peut pas écrire de fichier de rapport. Le faire recopier par Claude coûtait environ 25 000 tokens, inclus dans les 195k ; un script l'extrait maintenant du transcript du sous-agent ;
- La machine est prise pendant la délégation, et un seul appel local passe à la fois : si le GPU est occupé, le script refuse et Claude fait la tâche lui-même ;
- Le serveur local doit tourner. Le skill interdit à Claude de le démarrer sans mon accord.
Ce qu'il faut retenir
- Déléguez la recherche, gardez la rédaction : environ 195k tokens Claude au lieu de 842k pour une deep research, pour une qualité équivalente (32 sur 35 contre 33), alors que le tout local tombe à 26.
- Déléguez ce qui se lit beaucoup et se rend court : un log de 39 Ko coûte 965 tokens à Claude au lieu de 16 726.
- Ne comptez pas les tokens traités en local comme des tokens Claude évités : 466 000 tokens cumulés sur un ticket qui n'en aurait pas coûté autant à Claude.
- Comptez chaque reprise comme une perte : sur neuf deep research, 3 chercheurs locaux sur 32 ont dû être relancés.