Après 75 runs, le constat est net : un LLM local fait bien le travail cadré et vérifiable, beaucoup moins bien le travail de jugement. Il réussit 43 runs sur 45 sur les tâches bien spécifiées, mais seulement 13 sur 30 face à un bug à diagnostiquer ou un ticket flou. Le harnais change surtout la durée : Pi va environ 1,7 fois plus vite que les deux autres que j'ai testés.
Le besoin de départ prolonge mon article sur la réduction des tokens. Les plugins réduisaient ce que Claude Code lit et écrit. Ici, on sort une partie du travail de Claude pour la faire tourner sur la machine, avec Qwen3.8 27B sur une RTX 4090. Je ne compare pas Qwen à Claude : un run est réussi s'il passe les tests cachés de l'épreuve.
Faire tenir un LLM local dans 24 Go de VRAM
J'ai choisi ce modèle parce que, parmi ceux qui tiennent sur 24 Go, c'est le plus solide en tâches agentiques : Qwen annonce 73,0 sur Terminal-Bench 2.1. Les alternatives de taille comparable, plus rapides car en MoE (mixture of experts), sont loin derrière d'après NVIDIA : 15,2 pour gpt-oss-20b, 24,6 pour Nemotron 3.5 Lightning, 44,4 pour Qwen3.6-35B-A3B. Les scores ne viennent pas de la même source (Qwen pour son modèle, NVIDIA pour les autres), mais l'écart est net.
Dans sa version d'origine, le modèle pèse environ 55 Go, plus du double de la carte. Je le fais tourner en version compressée en 4 bits, publiée par Unsloth, une équipe qui prépare des versions allégées des modèles ouverts. Le fichier est au format GGUF, celui que lit llama.cpp, le moteur qui fait tourner le modèle sur la carte. Il en existe deux variantes proches : UD-Q4_K_XL et UD-Q4_K_M (16,5 Go), un peu plus légère. Reste à choisir la taille du contexte, c'est-à-dire combien de tokens le modèle garde en mémoire pendant une tâche : plus il est grand, plus il prend de VRAM. Voici ce que j'ai mesuré sur la carte.
| Contexte | Variante | VRAM totale | Génération |
|---|---|---|---|
| 64k | UD-Q4_K_XL | 20,4 Go | 79,9 tok/s |
| 160k | UD-Q4_K_XL | 23,2 Go | 75,2 tok/s |
| 192k | UD-Q4_K_XL | 23,4 à 23,8 Go | 13,9 tok/s |
| 192k | UD-Q4_K_M | 23,3 Go | 78,1 tok/s |
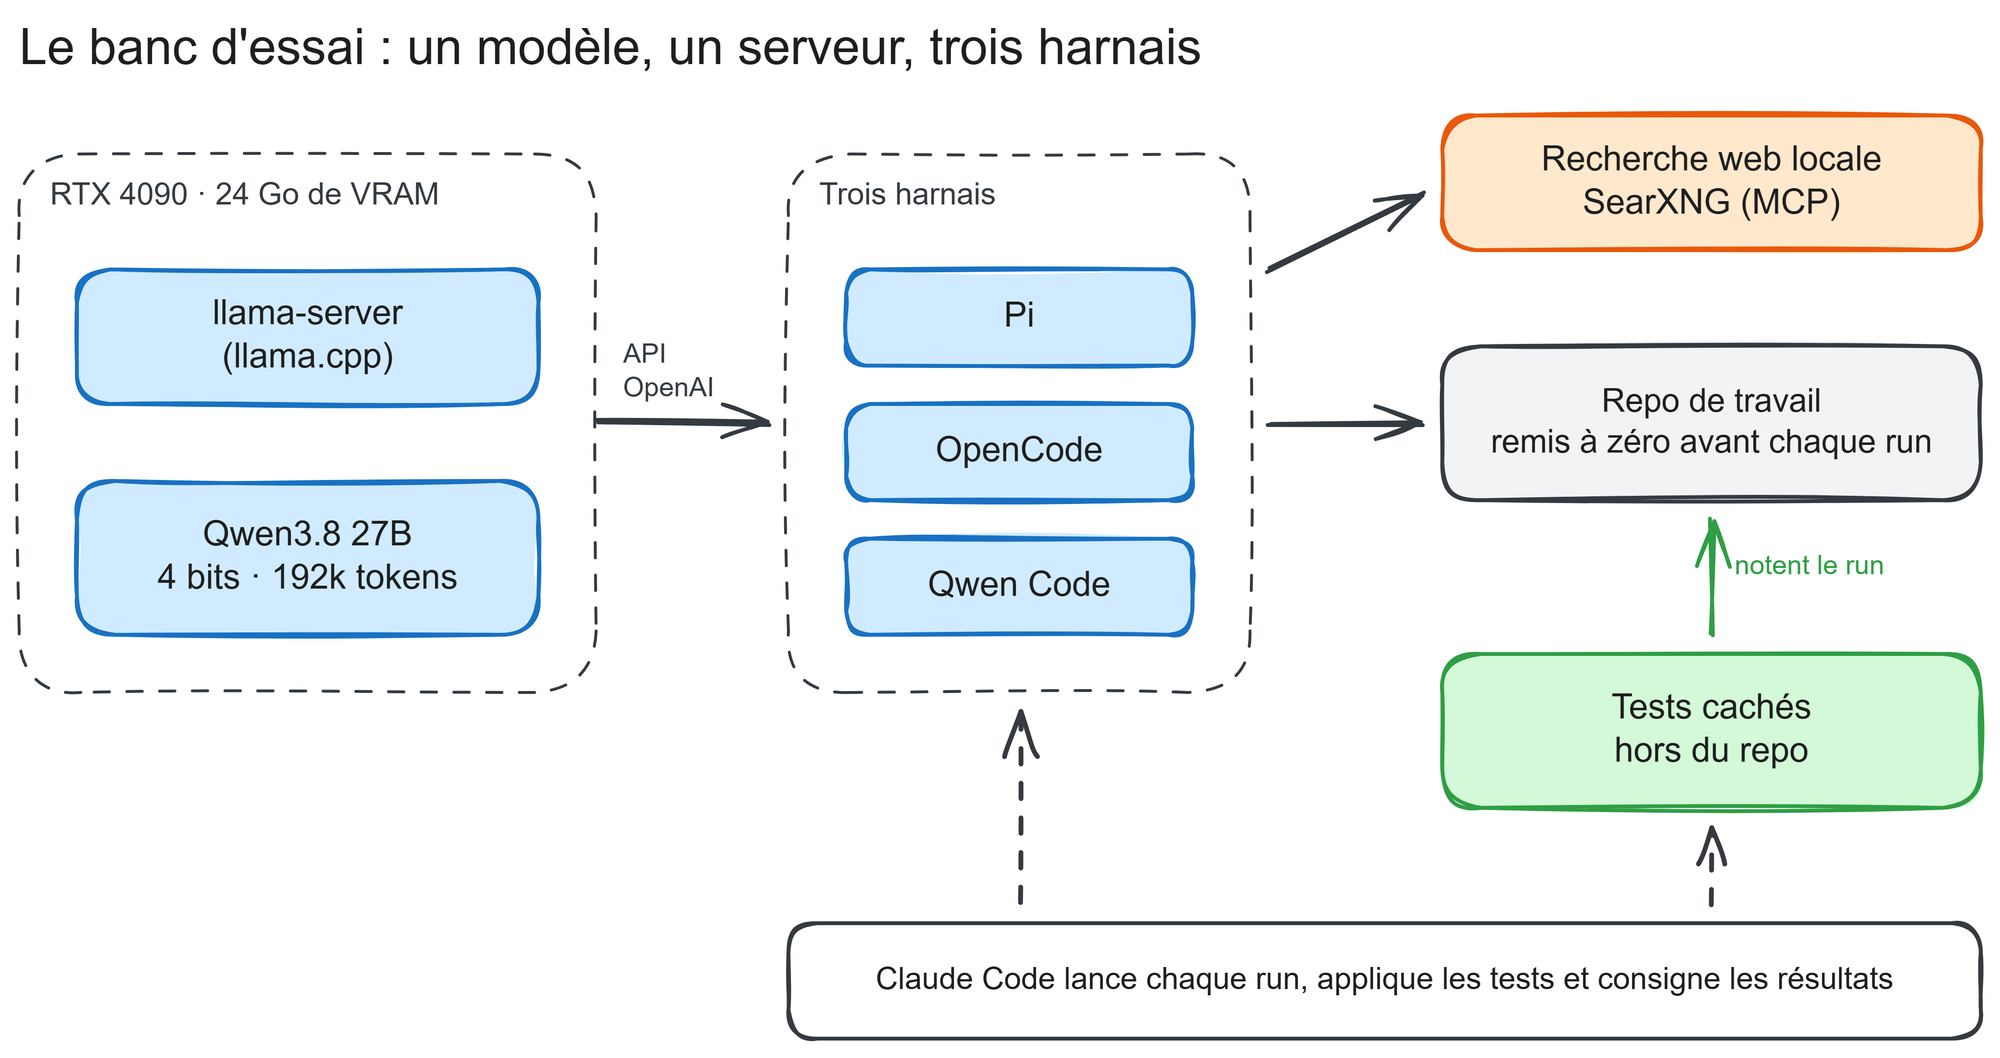
Avec la variante UD-Q4_K_M, le modèle tient donc sur la carte avec 192k tokens de contexte, à environ 78 tokens par seconde. Côté serveur, llama-server (llama.cpp) expose une API compatible OpenAI, sur laquelle n'importe quel harnais se branche.
Trois harnais pour un même LLM local
Un harnais, c'est le programme qui tourne autour du modèle : prompt système, outils, enchaînement des appels, sous-agents, permissions. Claude Code en est un. Concevoir ce programme, c'est l'objet du harness engineering ; en tester trois sur un même modèle montre ce qu'il change. Les trois retenus :
- Pi, le plus léger des trois ;
- OpenCode, une interface en terminal avec permissions et sous-agents ;
- Qwen Code, le harnais que recommande l'équipe Qwen.
L'overhead, c'est ce que le harnais envoie au modèle avant votre demande. Je l'ai mesuré pour les trois sur une requête minimale ("Réponds OK") : il dépasse les chiffres annoncés.
| Harnais | Overhead annoncé | Overhead mesuré | Ce qui est envoyé |
|---|---|---|---|
| Pi | moins de 1k tokens | ~6,5k tokens | 4 outils, 2 outils MCP, 28 skills globaux listés |
| Qwen Code | non publié | ~15,1k tokens | plus 2 petites requêtes annexes |
| OpenCode | ~7k tokens | ~17,9k tokens | plus une requête de titre de session (~0,7k) |
L'écart de Pi vient surtout de mes 28 skills globaux, listés dans son prompt. Sur 192k de contexte, l'overhead pèse peu : même 17,9k tokens restent sous 10 % de la fenêtre.
Claude Code peut lui aussi se brancher sur llama-server, mais je l'ai écarté sans le mesurer : un relevé publié lui prête environ 33 000 tokens d'overhead par requête, près de deux fois plus que le plus lourd des trois.
Les trois harnais partagent la même recherche web : un SearXNG en Docker, branché en MCP via mcp-searxng (deux outils : chercher, lire une page). Tout reste sur la machine, sans clé d'API.
Évaluer un LLM local : tests cachés et répétitions
Chaque épreuve est notée par des tests cachés, rangés hors du repo : l'agent ne peut ni les lire ni les adapter. Je les ai validés contre une solution de référence, puis j'ai supprimé la solution. Avant chaque run, le repo est remis à zéro ; pendant le run, aucune aide, mode non interactif, mêmes réglages (température 1,0, reasoning_effort: medium). Pour le ticket flou, aucun test ne tranche un design : chaque run écrit une note de décision, et c'est elle qui est évaluée.
Tout le banc d'essai a été orchestré depuis Claude Code : Claude a lancé chaque run, l'a noté et a consigné les résultats. Le modèle local n'a fait que le travail demandé.
Pourquoi répéter ? Je règle la température à 1,0, la valeur que Qwen recommande pour le mode réflexion : un run isolé peut donc tomber du bon ou du mauvais côté. Après un premier passage à un run par épreuve, j'ai monté chaque épreuve à 5 runs par harnais, soit 75 runs (les 60 ajoutés ont tourné en un peu moins de 5 heures). Seul le workflow BMAD, plus long, est à 3 runs par harnais.
Les répétitions ont invalidé tous les verdicts du premier passage qui distinguaient un harnais :
- Bug à diagnostiquer : au premier passage, seul OpenCode livrait le bon correctif. Sur 5 runs, il n'en réussit qu'un, contre 2 pour Pi et 1 pour Qwen Code ;
- Ticket flou : au premier passage, seul Qwen Code trouvait le bon design. Sur 5 runs, il reste devant (4), mais Pi en trouve 2 et OpenCode 3 ;
- Recherche web : au premier passage, seul Pi vérifiait ses sources. Sur 5 runs : Pi 5, OpenCode et Qwen Code 4 chacun, leurs ratés étant ceux du premier passage.
À l'inverse, les épreuves que les trois harnais réussissaient au premier passage ont été confirmées par les répétitions. Ces résultats restent limités à six épreuves, un modèle, une machine et 5 runs par harnais.
Ce qu'un LLM local réussit, épreuve par épreuve
Les durées sont des médianes sur 5 runs (la valeur du milieu, moins sensible à un run anormalement long).
Ticket bien spécifié : 15 runs sur 15
La tâche : un ticket d'emprunt de livres sur un faux projet, une API TypeScript en couches, avec 4 endpoints et 7 règles métier. Les trois harnais réussissent à chaque run : médiane de 3 min 17 pour Pi, 5 min 05 pour Qwen Code, 6 min 14 pour OpenCode.
Le diff de Pi, relu au premier passage, respecte les couches et les conventions, avec deux défauts mineurs. Un ticket bien spécifié comme celui-ci est donc le premier type de tâche à confier à un LLM local.
Bug à diagnostiquer : trouver la cause ne suffit pas
Le ticket ne donne que le symptôme : après une suppression, des identifiants de livres sont réattribués. La cause est trouvée vite (médianes de 1 min 11 à 2 min 10), mais seuls 4 runs sur 15 livrent un correctif juste : 2 sur 5 pour Pi, 1 sur 5 pour OpenCode et pour Qwen Code.
Les 11 ratés font tous la même erreur : un nouvel identifiant calculé en "max + 1", qui réutilise encore celui du dernier livre supprimé, alors que le ticket en donnait l'indice. Le bon correctif est un compteur qui ne redescend jamais. Cette tâche reste à garder pour Claude : le correctif superficiel passe les tests du repo, et l'erreur ne se voit qu'avec un test ciblé.
Ticket flou : le design reste aléatoire
Le ticket demande des réservations de livres, sans préciser les règles. Le bon design ressort 9 fois sur 15 : 2 sur 5 pour Pi (5 min 43), 3 sur 5 pour OpenCode (9 min 29), 4 sur 5 pour Qwen Code (11 min 12).
Le raté type fait expirer la réservation 7 jours après la demande. Or un emprunt dure 14 jours : réserver un livre déjà emprunté, le cas principal, ne sert presque jamais. Le bon design gèle la file pendant l'emprunt et compte les 7 jours à partir du retour du livre.
Qwen Code fait mieux que les deux autres, mais même lui rate un run sur cinq. Mieux vaut garder ce type de ticket pour Claude, ou le cadrer avant de déléguer : une fois le design tranché, la tâche redevient un ticket bien spécifié.
Vrai repo : commander.js, 15 runs sur 15
Pour sortir des faux projets, j'ai pris une vraie issue de commander.js (#2405), une bibliothèque Node.js très répandue pour écrire des outils en ligne de commande : environ 2 800 lignes, 1 349 tests. Les trois harnais passent à chaque run les 4 tests du vrai commit de correction : médianes de 4 min 13 pour Pi, 5 min 28 pour Qwen Code, 7 min 08 pour OpenCode. La solution des mainteneurs reste plus simple que les patchs obtenus.
La durée varie beaucoup entre runs identiques : de 3 min 22 à 16 min 51 pour Qwen Code, de 6 min 09 à 15 min 43 pour OpenCode. On peut déléguer ce type de correctif, à condition qu'il soit localisé dans un repo propre et testé.
Recherche web locale : 13 runs sur 15
La tâche : trouver la version npm du jour d'un paquet, puis lire une page. Pi réussit 5 fois sur 5 (23 s), OpenCode 4 fois (29 s), Qwen Code 4 fois (44 s).
Les deux ratés datent du premier passage : OpenCode et Qwen Code ont cru un extrait de résultat de recherche qui n'était pas à jour, là où Pi est allé lire le registre npm. Une recherche simple se délègue bien, si la consigne impose de vérifier la source.
Workflow BMAD : le harnais change la manière (3 runs par harnais)
Dernière épreuve, un projet neuf (une CLI TypeScript) avec BMAD v6.12.4 : planification du sprint, puis première story, sur 3 runs par harnais. Les trois passent les 5 tests cachés à chaque run ; ce qui change, c'est la manière et la durée :
- Pi n'a pas de sous-agents : la revue est écrite dans un fichier, à relancer à la main dans une autre session (8 à 10 min, un relais manuel par run) ;
- OpenCode lance 6 sous-agents, dont 3 revues en parallèle, et c'est le plus irrégulier : 18 min sans aucune intervention sur un run, environ 2 h sur un autre, où la revue a relancé un second tour ;
- Qwen Code fait une revue en trois couches, rigoureuse : au premier run, elle trouve un trou dans la spec et régénère le code ; au deuxième, elle me pose la question (que faire d'un fichier de données corrompu ?). Entre 24 et 65 min.
Sur 3 runs, la qualité ne départage pas les harnais ; ce qui les sépare, c'est la structure (avec ou sans sous-agents) et la régularité de la durée. Ce workflow se délègue en tâche de fond, si la durée n'est pas un problème.
J'ai ensuite confié une vraie story à chaque harnais, sur un projet Next.js (5 critères d'acceptation, un run chacun). Les trois livrent un résultat commitable, tests au vert, mais en 3 à 4 h de travail ; la revue en trois couches est la phase la plus longue.
| Épreuve (5 runs par harnais) | Pi | OpenCode | Qwen Code |
|---|---|---|---|
| Ticket bien spécifié | 5/5 · 3 min 17 | 5/5 · 6 min 14 | 5/5 · 5 min 05 |
| Bug à diagnostiquer | 2/5 · 1 min 11 | 1/5 · 2 min 02 | 1/5 · 2 min 10 |
| Ticket flou (bon design) | 2/5 · 5 min 43 | 3/5 · 9 min 29 | 4/5 · 11 min 12 |
| commander.js #2405 | 5/5 · 4 min 13 | 5/5 · 7 min 08 | 5/5 · 5 min 28 |
| Recherche web | 5/5 · 23 s | 4/5 · 29 s | 4/5 · 44 s |
| Total des 4 épreuves de code (somme des médianes) | 14 min 24 | 24 min 53 | 23 min 55 |
Ce qu'on peut confier à un LLM local, et ce qu'on garde pour Claude
Le partage suit la nature de la tâche, pas le harnais : ce qui est cadré et vérifiable passe, ce qui demande du jugement reste fragile.
| Besoin | Délégable au local ? | Résultat | Condition |
|---|---|---|---|
| Ticket bien spécifié | Oui | 15 runs sur 15 | Repo propre et testé |
| Correctif localisé sur un vrai repo | Oui | 15 runs sur 15 | Tests existants qui couvrent le cas |
| Recherche web simple | Oui | 13 runs sur 15 | Consigne de vérifier la source |
| Story BMAD en tâche de fond | Oui, si le temps n'est pas un problème | 5/5 en tests cachés, 3 runs par harnais | De 8 min à ~2 h |
| Bug à diagnostiquer | Non | 4 runs sur 15 | Le correctif superficiel passe les tests |
| Ticket flou, décision de design | Non, ou après cadrage | 9 runs sur 15 | Trancher le design avant de déléguer |
Pour le choix du harnais, à taux de réussite comparable, Pi est le plus rapide : 14 min 24 sur les quatre épreuves de code, contre 23 min 55 pour Qwen Code et 24 min 53 pour OpenCode, soit environ 1,7 fois moins de temps. Il se lance aussi en une ligne de commande, facile à scripter. OpenCode ou Qwen Code ne se justifient que pour BMAD, grâce à leurs sous-agents (constat sur 3 runs).
Reste à mesurer ce que la délégation retire vraiment à Claude, quand c'est lui qui confie ces tâches au modèle local : ce sera l'objet d'un prochain article.
Le coût réel d'un LLM local
Le temps d'abord : un workflow BMAD monte jusqu'à environ 2 h, et deux runs identiques peuvent durer plus de six fois plus longtemps l'un que l'autre. Puis la friction, surtout en mode non interactif :
- OpenCode a des permissions prudentes par défaut, qui interrompent le run : lecture hors du dossier, fichiers dont le nom contient
.env., même un fichier de test ; - Le lanceur npm de Qwen Code perd la variable qui désigne sa configuration et retombe sur une autre installation ;
- Côté serveur, la RAM est montée à 29 Go après une trentaine de runs (cache des prompts), jusqu'à ce que je la plafonne ;
- La carte graphique est monopolisée : un jeu lancé pendant un run sature la VRAM et fige l'agent.
Ce qu'il faut retenir
- Déléguez d'abord le travail cadré et vérifiable. Ticket bien spécifié, correctif localisé, recherche simple : 43 runs réussis sur 45.
- Gardez pour Claude le diagnostic et le design. 13 runs réussis sur 30, quel que soit le harnais.
- Choisissez le harnais sur le temps, pas sur la réussite. À taux comparable, Pi met 14 min 24 contre 23 min 55 à 24 min 53.