Depuis vingt ans, le self-service data accumule les dashboards sans résoudre le problème : les équipes data répondent toujours aux mêmes questions ad-hoc. L'analytics agent change enfin la donne - non parce que les LLMs ont progressé, mais parce que des équipes comme nao Labs ont compris une vérité contre-intuitive : le modèle est la variable la moins importante de l'équation. C'est ce que Claire Gouze, co-fondatrice de nao Labs (YC X25), est venue démontrer chiffres à l'appui lors du meetup Radio Data SFEIR.
LLM + semantic layer : pourquoi cette stack analytique reste insuffisante
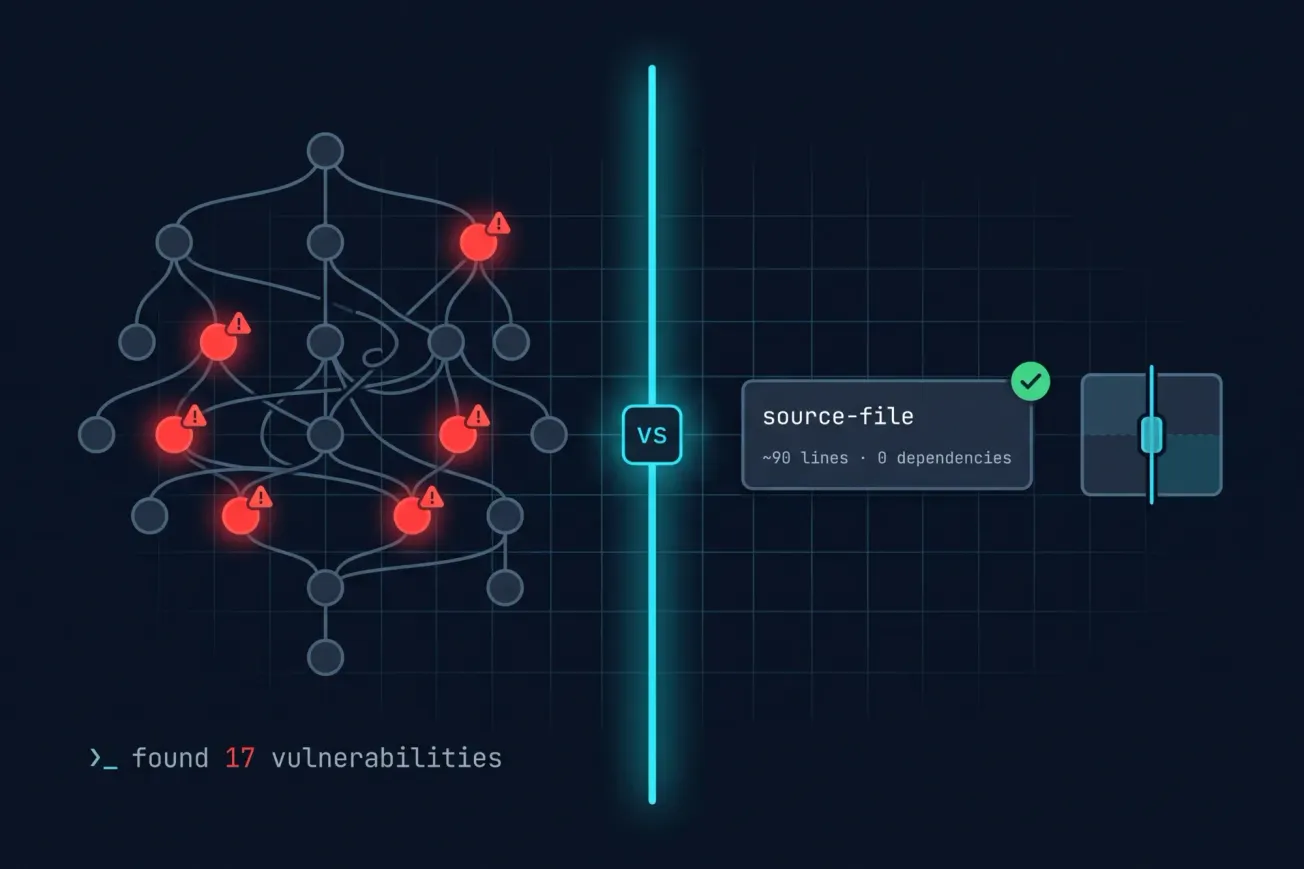
Brancher un LLM sur une base de données de production sans contexte structuré produit un résultat précis : 17 % de bonnes réponses. C'est le chiffre mesuré par nao Labs sur leurs propres données. Le LLM ne connaît pas vos conventions de nommage, vos définitions métier, ni quelle table "gold" utiliser quand trois tables ont des noms similaires. Il génère du SQL plausible - pas du SQL juste.
La réponse de l'industrie a été d'ajouter une semantic layer - Cube, dbt Semantic Layer - exposée via MCP. Mieux, mais insuffisant. Une semantic layer apporte de la connaissance déclarative (ce que signifient vos métriques) sans la connaissance procédurale : comment naviguer dans vos données, dans quel ordre interroger les tables, quels cas aux limites gérer. Elle coûte cher en tokens, introduit de la latence via l'appel réseau intermédiaire, et crée une dépendance à un vendeur dont vous ne contrôlez pas le roadmap.
Exemple concret : interroger une semantic layer via MCP ajoute 200-500ms de latence par requête et multiplie par 3 le coût en tokens comparé à un context layer local. Pour un agent sollicité 1000 fois/jour, cela représente 8-15 minutes de latence cumulée et des coûts API qui explosent à l'échelle.
On donnait à l'agent une carte - il savait ce qui existe. L'enjeu aujourd'hui est de lui donner un GPS : comment naviguer, quelle source consulter, dans quel ordre, à quoi ressemble une bonne réponse.
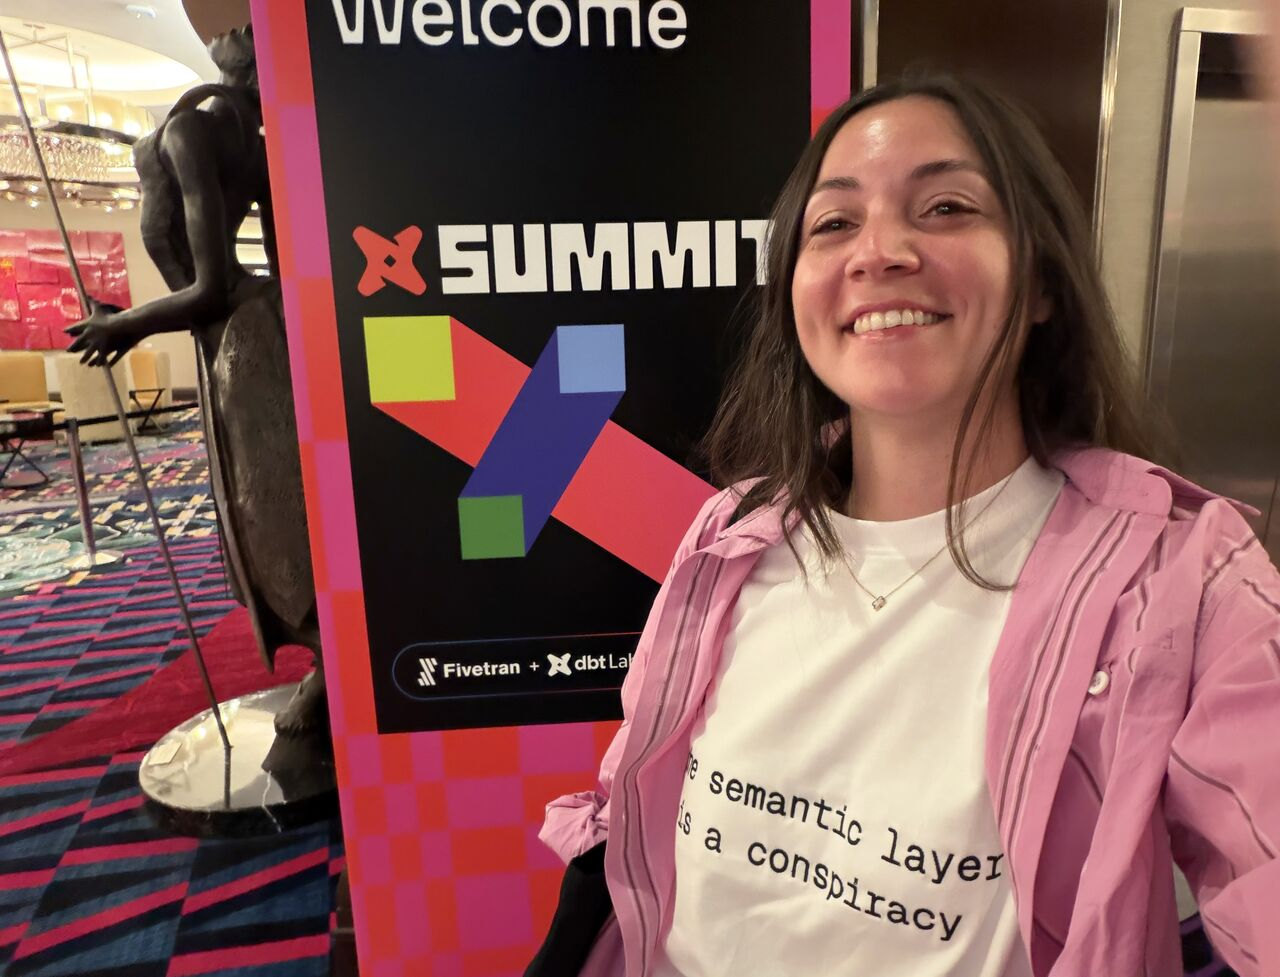
Claire est d'ailleurs arrivée au dbt Summit avec un t-shirt "semantic layer is a conspiracy" 😁 pas pour dire que la semantic layer est inutile, mais que la forcer via MCP est un vendor lock-in masqué en best practice.
Context engineering : de 17 % à 86 % de fiabilité sans changer de modèle
En 2025, Anthropic a publié le détail de son agent d'analytique interne. Sans couche de contexte procédurale, Claude obtenait 21 % de réponses correctes sur ses données internes. En encodant les processus d'analyse métier comme "skill files" - de la connaissance procédurale - la précision dépasse 95 %. Le modèle n'a pas changé. La suite est édifiante : un mois plus tard, la fiabilité est retombée à 65 % parce que le contexte avait dérivé sans processus de maintenance. Le context engineering n'est pas un one-shot : c'est un processus continu.
Nao Labs a mesuré la même dynamique sur ses propres données : 17 % à 86 % de fiabilité en empilant les couches - schéma de tables, modèles dbt, profiling, règles métier, documentation enrichie, puis refonte du data model.
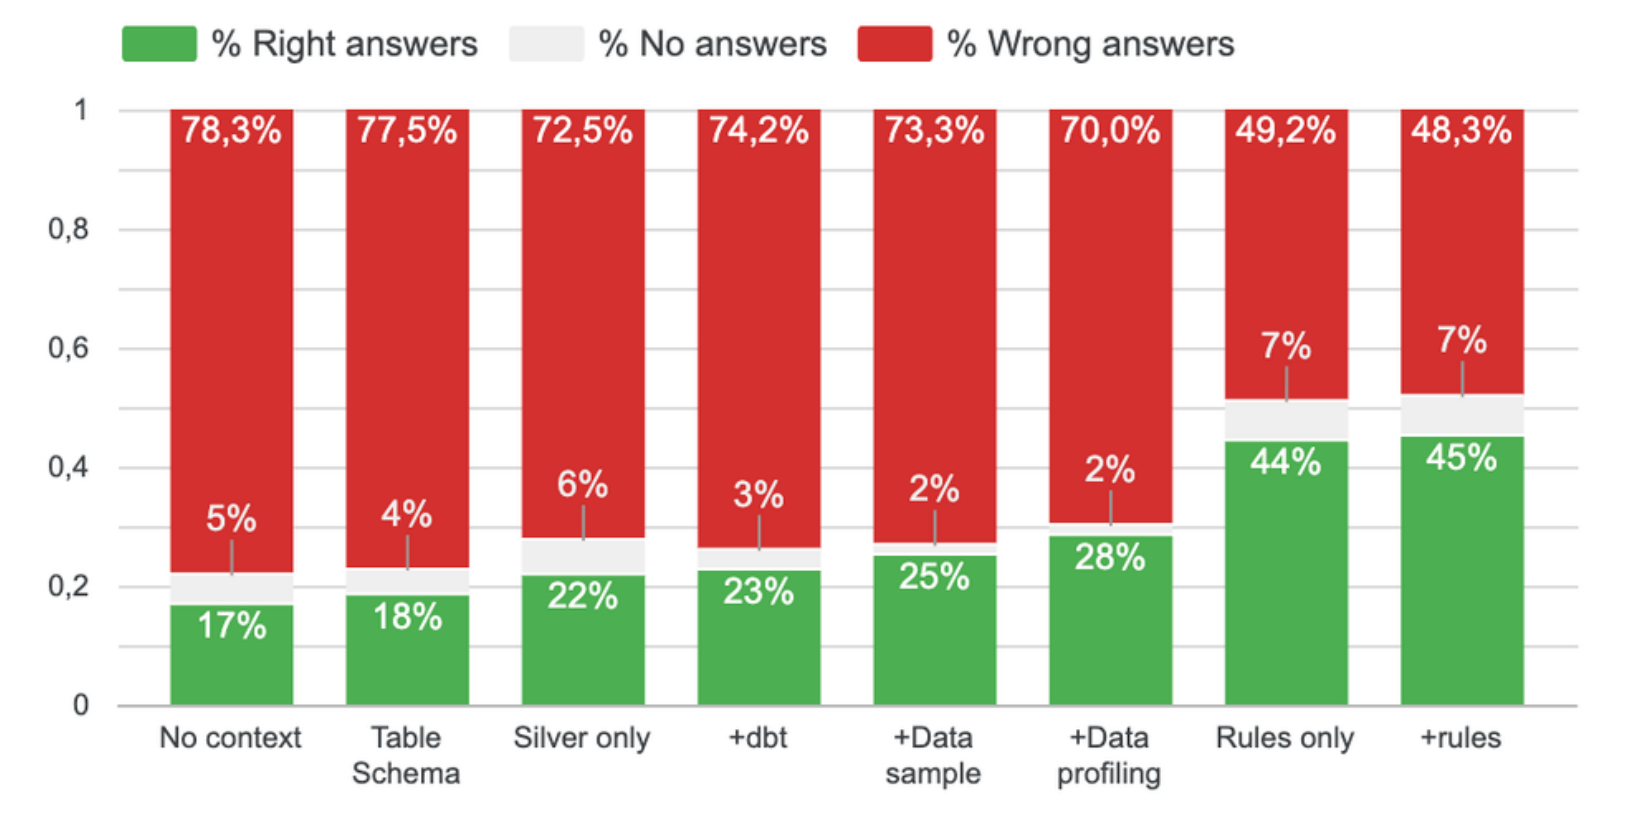
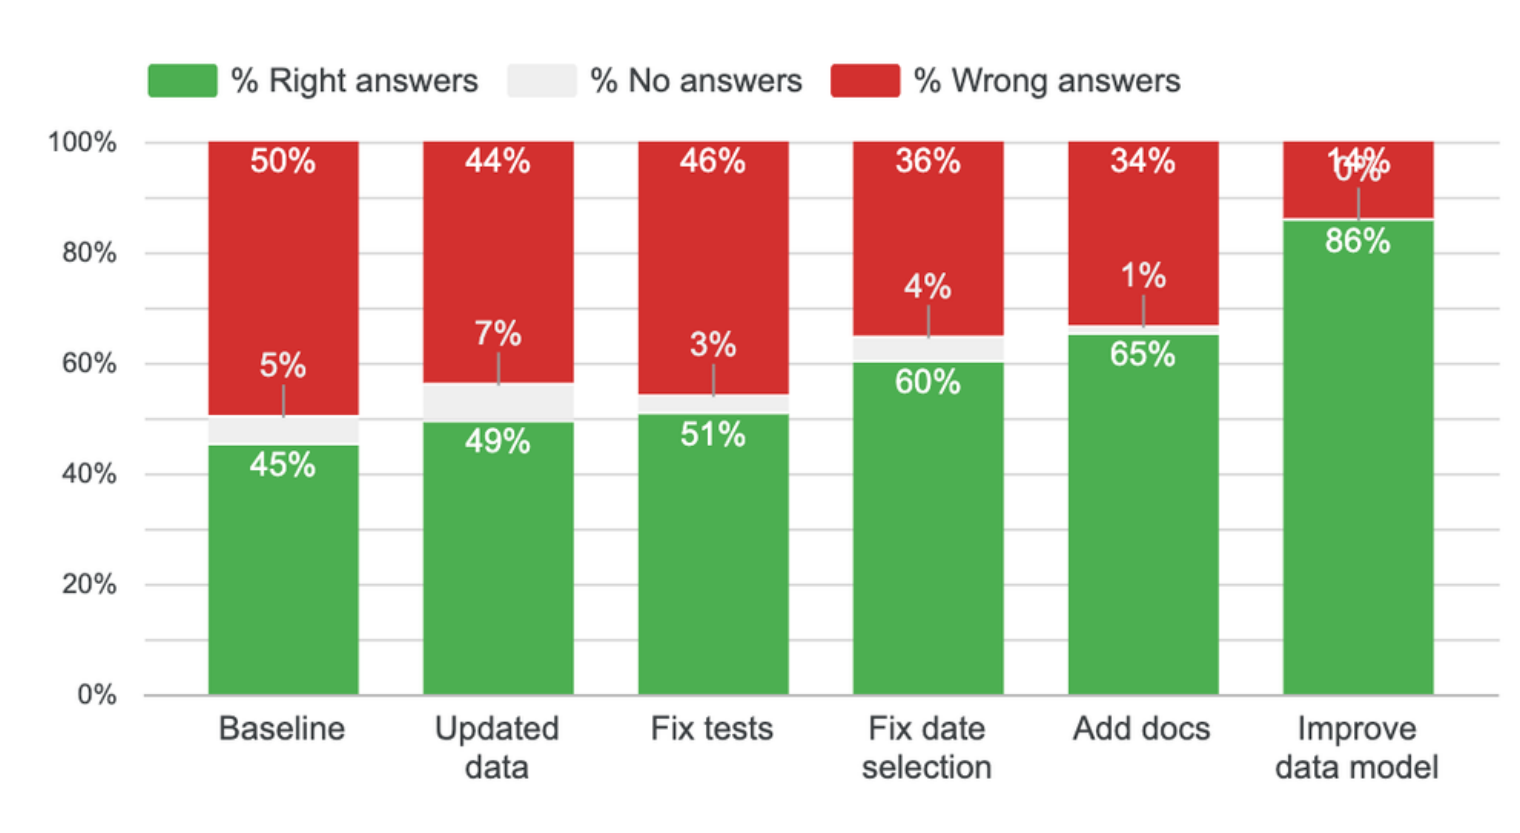
Le chiffre le plus opérationnel vient de l'expérience directe de Claire Gouze, partagée dans un podcast avec Tristan Handy (dbt Labs) : nettoyer les modèles dbt et améliorer leur documentation a fait passer la fiabilité de son analytics agent de 40 % à 90 %. Pas de nouveau LLM, pas de nouveau framework. Du bon data modeling.
"80 % du context engineering, c'est du data modelling. Pas de la magie de prompt, pas du choix de modèle. Le principal levier de performance d'un analytics agent, c'est la qualité du modèle de données et de sa documentation." - Claire Gouze, podcast Data Hustle
L'architecture open source de nao Labs : file-system, dbt et CI/CD
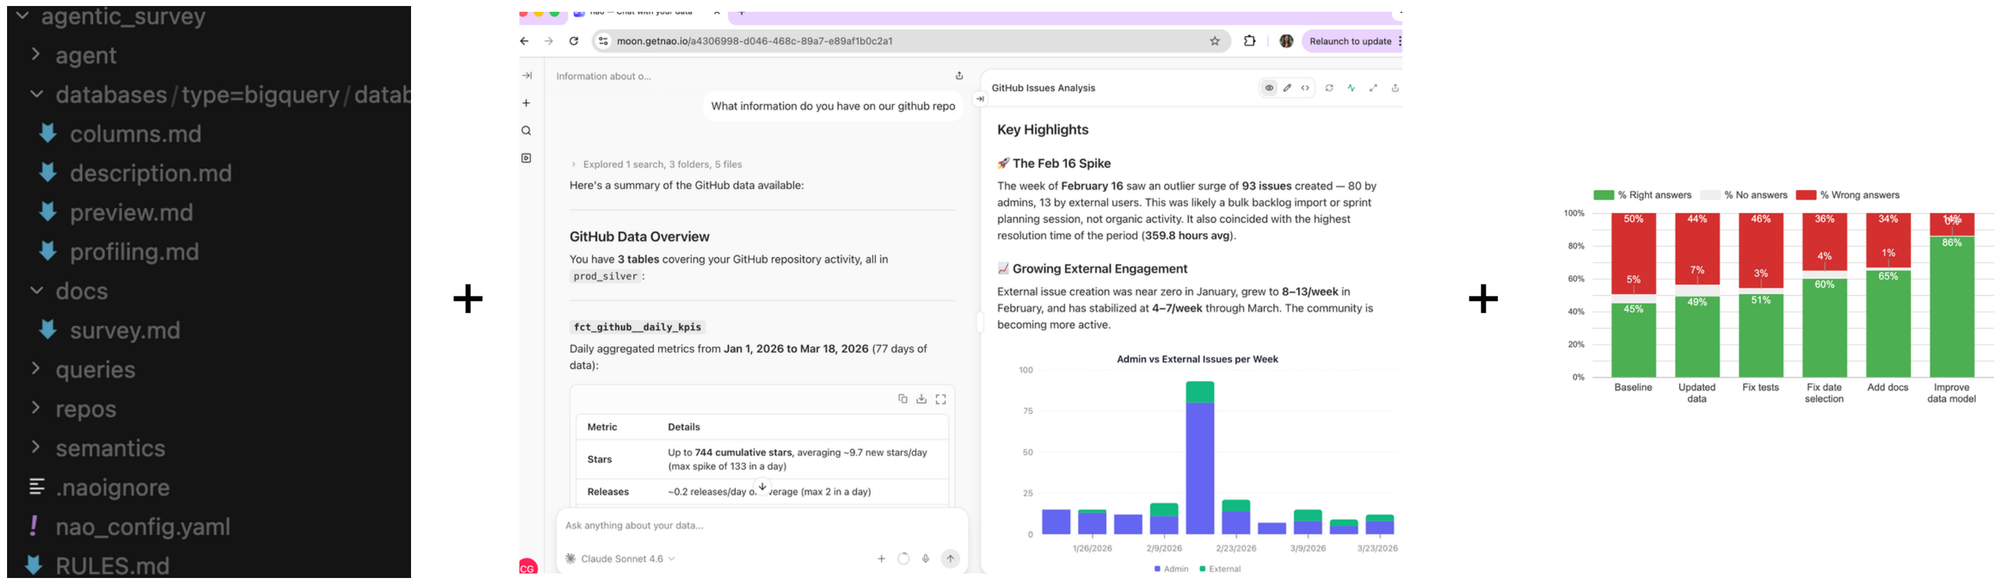
Le framework nao (Apache 2.0, ~1 900+ étoiles GitHub, 70 contributeurs, 200 entreprises en production) s'articule autour d'une décision d'architecture simple : le context layer est un répertoire Git que vous possédez.
Un context layer versionné as-code
nao core crée un dossier versionné contenant des fichiers Markdown décrivant tables, colonnes, règles métier et exemples de requêtes. nao sync synchronise ce dossier avec vos sources - warehouse, repos dbt, documentation Markdown. Changer de LLM ou migrer de warehouse ne touche pas à votre contexte : c'est du code, c'est le vôtre. Zéro vendor lock-in.
Intégration dbt et MetricFlow sans MCP
Quand vous utilisez MetricFlow, nao le fait tourner comme compilateur SQL interne - les métriques sont résolues de façon déterministe, sans appel réseau à dbt Cloud, sans plan Semantic Layer payant. Latence supprimée, vendor lock-in éliminé.
CI/CD pour la qualité de l'analytics agent
nao test exécute une suite d'évaluations offline - des paires question/SQL attendu - avant tout déploiement. Un changement de schema qui casse le comportement de l'agent est détecté avant de toucher les utilisateurs. C'est l'approche qu'Anthropic décrit explicitement : traiter le context engineering comme du fine-tuning ML, avec des tests déterministes à chaque itération de contexte.
Maintenance automatique du contexte
nao analyse les conversations réelles des utilisateurs, identifie les lacunes du context layer, et ouvre automatiquement une PR dans le repo de contexte avec les corrections proposées. Le contexte s'améliore au rythme des usages - toujours versionné, toujours auditable. C'est la réponse opérationnelle au problème qu'Anthropic a découvert à ses dépens : un contexte non maintenu dérive, et la fiabilité s'effondre avec lui.
Fiverr, PrestaShop : des analytics agents en production - et leurs prérequis
Fiverr : Fibi, un analytics agent enterprise-grade
Fiverr a construit Fibi - leur propre BI agent - sur le framework nao, déployé à l'échelle de l'entreprise. Le VP Data Anton Barr détaille le périmètre : access control via Okta, row-level security par utilisateur ou équipe, AI budget management, guardrails et validations. Fiabilité atteinte : "near the industry's best accuracy reported by Anthropic" - soit ~95 %. Trois mois de développement pour un déploiement company-wide. C'est de l'enterprise-grade, pas un POC.
PrestaShop : du self-service analytique en une semaine
PrestaShop a atteint le self-service conversationnel en une semaine, en important son contexte existant - repo Dataform, repo Looker - directement dans nao sur BigQuery. Pas d'outillage à migrer, pas d'ontologie supplémentaire à construire. La conclusion de leur Data Engineer Nelson Lopez : "nao does not replace the data team. It multiplies its reach."
Ces deux cas partagent un prérequis implicite : les équipes data avaient déjà un data model solide et une documentation existante. C'est là que la limite se dessine honnêtement. Si vos tables sont ambiguës, mal nommées ou non documentées, aucun analytics agent ne compensera. Le context engineering révèle la qualité du data modeling - il ne s'y substitue pas.
Les agents sont les nouveaux dashboards. Ils balaient le cimetière que vous avez accumulé depuis dix ans - parce qu'un agent n'est pas figé sur un périmètre, il s'adapte à ce que vous cherchez à comprendre aujourd'hui. - Claire Gouze, podcast Data Hustle
Ce que l'analytics agentique change concrètement pour vos équipes data
La question que ce REX pose aux Data Engineers et Lead Data n'est pas "quel outil adopter ?" mais "mon data model est-il assez solide pour devenir la fondation d'un context layer ?"
Checklist pour évaluer votre maturité context engineering :
- Vos tables ont-elles des noms explicites et cohérents ?
- Vos modèles dbt sont-ils documentés (descriptions, tests) ?
- Vos métriques business ont-elles des définitions écrites et versionnées ?
- Pouvez-vous expliquer à un LLM comment naviguer vos données, pas seulement ce qu'elles contiennent ?
Si vous répondez "non" à plus de deux questions, votre priorité n'est pas l'analytics agent - c'est le data modeling. Et c'est une excellente nouvelle : contrairement au fine-tuning d'un LLM, c'est un investissement que vous contrôlez entièrement.
Les équipes qui ont déjà de bonnes pratiques dbt - documentation propre, modèles bien nommés, définitions métier claires - sont mieux positionnées que celles qui cherchent un raccourci dans l'outillage. La valeur de l'expertise data ne disparaît pas avec les analytics agents : elle se déplace vers la construction et la maintenance du context layer. Et la capacité à mesurer précisément l'impact de chaque amélioration du data model sur la fiabilité de l'agent - via nao test - change fondamentalement comment on itère sur la qualité de la donnée.
Comme le résume Dennis Uhrskov Raagaard, Director of Data chez Nexus Mods, après avoir mis nao en production : "Models are becoming a commodity. Your context is the moat."
Article rédigé à partir du talk de Claire Gouze (nao Labs) lors du meetup Radio Data SFEIR.