Le prototype de l'épisode 1 marchait. Il était aussi fragile qu'un plan d'entraînement écrit sur un post-it. Voici ce qui s'est passé quand j'ai décidé d'en faire un projet sérieux, le soir et le week-end, puis de l'ouvrir à tous. Octobre est le mois de l'open source : c'est le bon moment pour vous le présenter.
TL;DR
- Le prototype "zéro code" de l'article précédent est devenu un projet Claude Code : un serveur MCP Python, des skills, une quarantaine de tools, près de 800 tests, une CI.
- La décision structurante : séparer strictement la méthodologie (des règles en Markdown que Claude lit) de la donnée (du Python pur, testé, que Claude appelle).
- Les bugs qui m'ont coûté le plus cher n'étaient pas des hallucinations. C'étaient des bugs d'intégration classiques, parfois de débutant, que l'IA ne voyait pas mieux que moi.
- Un outil qui devine une structure est plus dangereux qu'un outil qui refuse. Il m'a fallu une séance ratée sur la montre pour l'écrire noir sur blanc.
- La vraie compétence n'est pas de faire confiance à l'IA. C'est de la contraindre, puis d'auditer ce qu'elle a produit.
- Avec un assistant, réinventer la roue coûte cinq minutes. Une issue bien rédigée sur la bibliothèque a coûté moins, et sert à d'autres.
- Tout ce qui dépendait d'un fournisseur est passé derrière une interface neutre, avec un test qui l'y maintient : l'appareil (Garmin, via une couche provider), le sport (la course) et l'agent (Claude Code).
- C'est un projet personnel, développé sur mon temps libre, le soir et le week-end.
- Le projet est désormais un logiciel libre (AGPL-3.0), conçu pour accueillir d'autres appareils (montres, compteurs vélo), d'autres sports et d'autres agents, et ouvert aux contributions, avec des issues prêtes à prendre.
Ce que fait le coach aujourd'hui
Pour ceux qui n'ont pas lu le premier épisode, voici ce que fait le projet, concrètement, depuis une simple conversation avec l'IA :
- Il fait connaissance avec vous : il lit votre historique sur la montre, calcule votre VDOT (formule de Daniels) à partir d'une course récente, et en déduit vos allures d'entraînement et vos zones cardiaques.
- Il construit votre plan : un plan périodisé (Base, Build, Peak, Taper, avec des semaines de récupération) vers votre course objectif, qui tient compte de vos contraintes, par exemple « 45 minutes maximum le lundi » : ce jour-là, il prévoit un footing, et garde la séance de qualité et la sortie longue pour les jours plus longs.
- Il pousse les séances sur votre montre : une fois le plan validé, il programme d'un coup plusieurs semaines de séances dans le calendrier de la montre (deux par défaut, jusqu'à quatre). Fractionné, tempo, sortie longue avec bloc d'allure, avec échauffement et retour au calme au bouton lap. Les footings ne sont pas envoyés : ils se courent au ressenti.
- Il vérifie votre forme chaque matin : il croise HRV, sommeil, stress, charge d'entraînement et votre ressenti, puis vous dit s'il faut maintenir la séance, l'alléger, la remplacer par un footing, ou vous reposer.
- Il analyse vos sorties : il compare ce que vous avez couru à ce qui était prévu, marque les séances faites, et suit la charge dans le temps (forme, fatigue, fraîcheur).
- Il tient compte des blessures : une douleur signalée revient à chaque retour de séance et à chaque nouveau plan, jusqu'à ce qu'elle soit levée.
- Il vous prépare pour le jour J : état de préparation, prédictions de chrono, stratégie d'allure découpée en segments.
- Il garde une trace : plan, fiche coureur et journal des décisions en Markdown, lisibles sur votre téléphone via Google Drive ou Obsidian.
Le tout en français ou en anglais, avec Strava en secours si la montre ne répond pas. Je n'ai trouvé aucune appli qui fait tout cela à la fois. Et celle-ci est libre et gratuite.
Là où on s'était arrêtés
Dans le premier épisode, l'architecture tenait en trois briques : Claude Desktop, un serveur MCP Garmin communautaire, et un skill Markdown qui décrivait un mini-DSL pour les séances. Fiabilité passée de 20 % à 95 % grâce au DSL. Objectif 10 km manqué (42'46), non pas à cause de l'outil, mais de ma discipline.
J'avais listé les limites honnêtement : un contexte qui s'alourdit, la peur de perdre le fil, un coût en tokens qui pique. Ce que je n'arrivais pas à bien gérer : tout le savoir du système vivait dans la conversation. Le VDOT, les allures, les contraintes, l'historique des séances ratées. Fermer la fenêtre, c'était perdre un peu de contexte, même dans un projet Claude.
Alors en mai, sur mon temps libre, j'ai ouvert un dépôt Git. Le projet est resté ce qu'il était au départ : un projet personnel, développé le soir et le week-end, entre deux sorties.
Ce que j'ai construit
Le projet est né comme un projet Claude Code : un dépôt qu'on ouvre comme espace de travail, qui embarque un serveur MCP écrit en Python avec FastMCP et des skills. Il ne dépend plus de Claude Code (on y revient en découverte 9), mais c'est l'environnement que j'utilise au quotidien. Ouvrir le repo dans Claude Code suffit : le fichier .mcp.json lance le serveur, qui s'authentifie à Garmin Connect (et Strava pour récupérer les séances en secours), et expose ses outils à Claude.
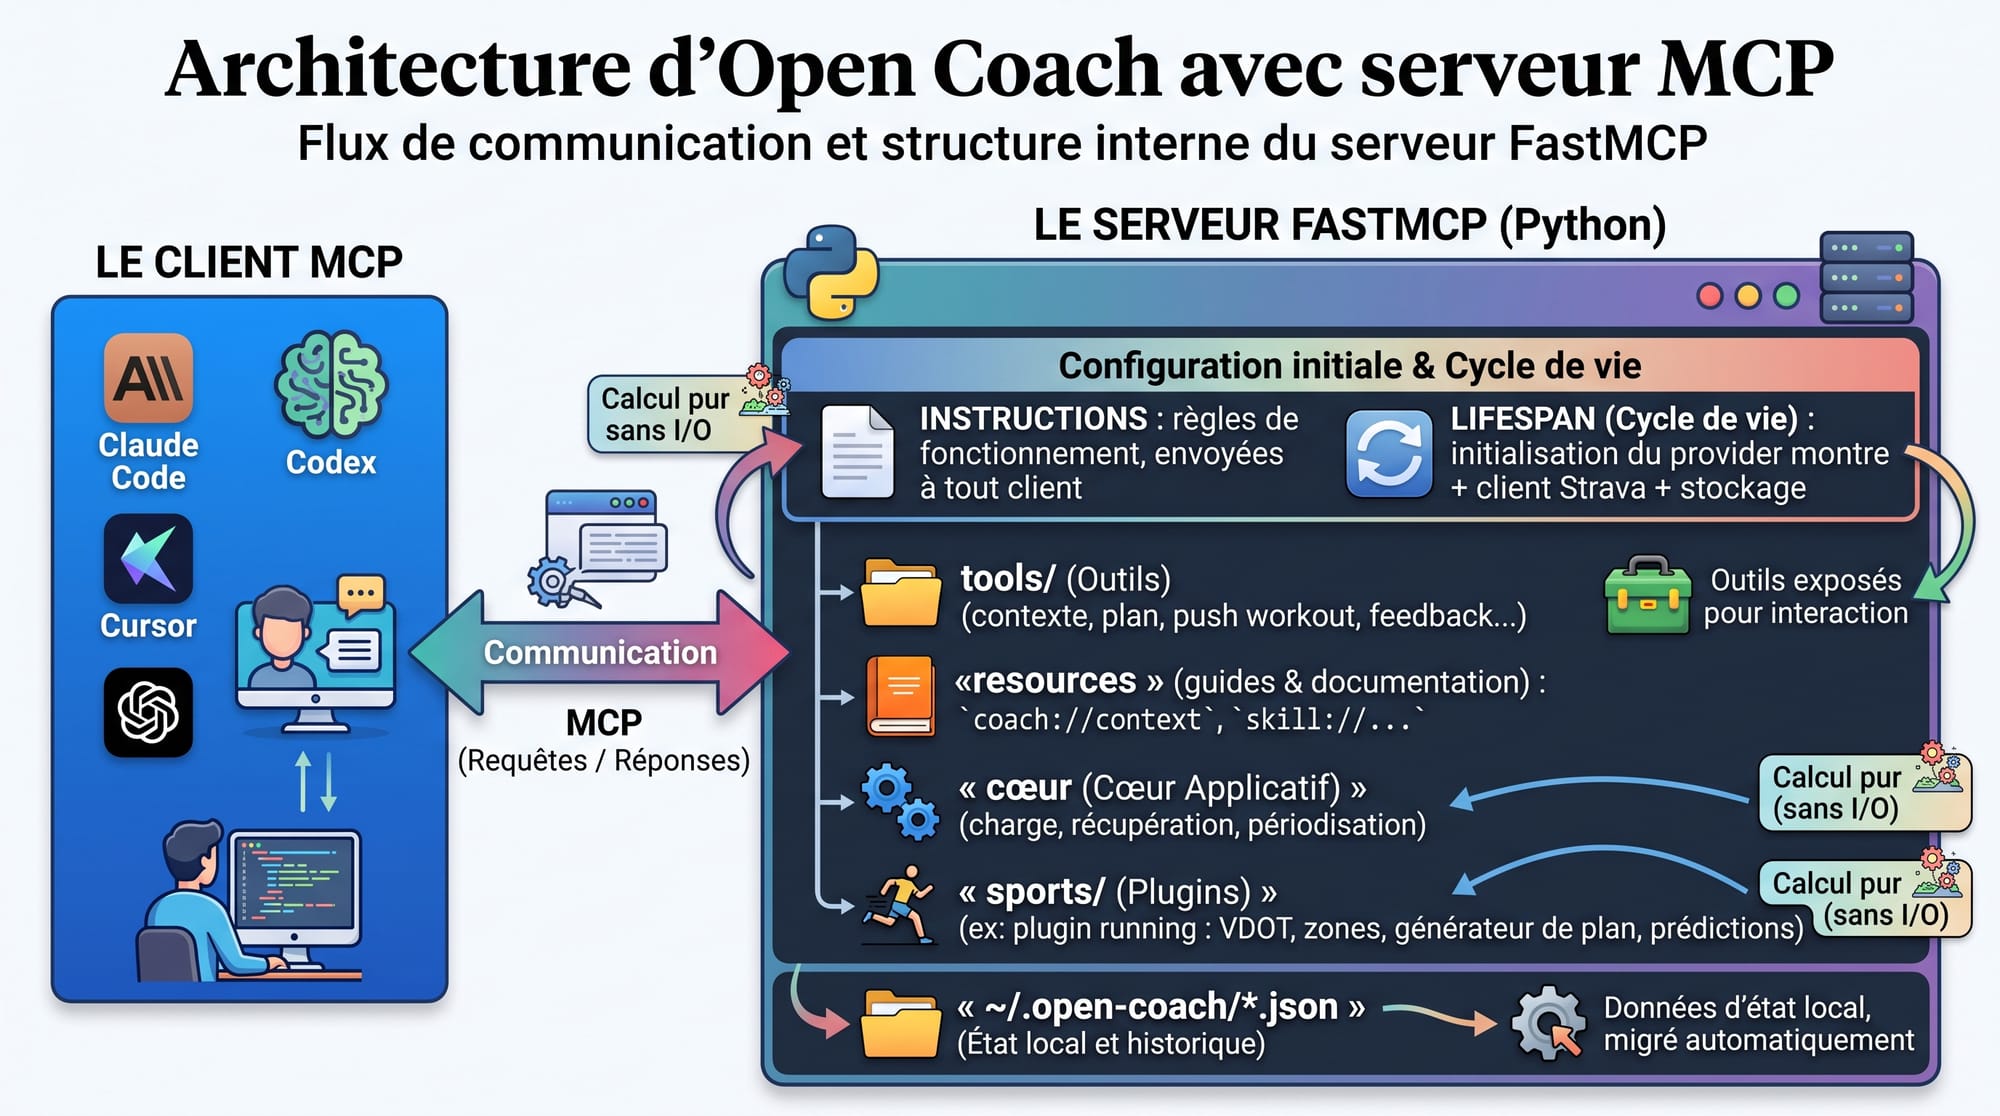
Aucun tool ne parle directement à Garmin. Ils passent tous par une couche provider (le dossier providers/ du dépôt) : une interface neutre qui décrit ce qu'on attend d'un appareil d'entraînement (lire les activités, la fréquence cardiaque, les signaux de récupération, recevoir des séances structurées), avec ses propres modèles de données. Garmin n'en est qu'une implémentation, isolée dans trois fichiers, et un test échoue si son nom apparaît ailleurs dans le code. Brancher une autre marque, COROS, Suunto ou Polar, revient à écrire un nouveau provider, sans changer aucun tool.
Le mot « montre » est d'ailleurs trop étroit. Un provider représente une plateforme, pas un poignet. Un compteur GPS vélo Garmin Edge, par exemple, envoie déjà ses sorties sur le même compte Garmin Connect, donc dans le provider existant : pour qu'il soit coaché et reçoive ses séances, il manque le plugin vélo (on y vient juste après) et la traduction des séances vélo au format Garmin. Un compteur d'une autre marque, Wahoo ou Hammerhead, serait simplement un provider de plus.
Même logique pour la langue : les plans et les descriptions de séances sont générés en français ou en anglais selon le profil de l'athlète.
Et, depuis peu, même logique pour le sport. Le cœur ne sait plus ce qu'est la course à pied : charge d'entraînement, récupération, périodisation, stockage et calendrier de la montre manipulent des types neutres (un sport, une intensité, un volume). Tout ce qui est propre à la course, le VDOT de Daniels, les zones d'allure, le générateur de plan, les prédictions de chrono, vit dans un plugin sports/running/, et un test échoue si du code running réapparaît dans le cœur. Le vélo et la natation, pour un futur coach triathlon, seront des plugins de plus. Comme le format des données a changé en route, un mécanisme de migration convertit tout seul les fichiers existants à la première lecture, en gardant une copie de l'original.
Au-dessus du serveur, deux couches de skills, au format ouvert Agent Skills :
- Les règles de coaching. coaching-rules porte ce qui vaut pour tous les sports : 80/20, progression de la charge, semaines de récupération, fiche athlète et journal. Chaque sport y ajoute les siennes : coaching-rules-running porte Daniels, la périodisation course, les anti-patterns et les conventions du DSL. Pas une ligne d'I/O. L'agent les lit avant toute recommandation.
- Six skills de workflow (onboard, plan-training, push-workout, analyze-run, daily-check, race-ready) : des procédures qui enchaînent les tools MCP et renvoient aux règles.
À côté du JSON, chaque plan actif est aussi rendu en Markdown dans un dossier plans/ ignoré par Git, avec une fiche coureur et un journal. Ce dossier est synchronisé avec un dossier Google Drive par un script rclone entièrement hors du serveur MCP : Drive est la source de vérité, le dépôt est bidirectionnel, et mon coffre Obsidian n'en est qu'un miroir en lecture seule. Je relis mon plan sur mon téléphone, le coach l'édite depuis Claude Code, et personne ne se marche dessus.
Un exemple concret de ce que fait le système un mardi matin : je demande « je m'entraîne dur aujourd'hui ? ». Le skill daily-check lit le contexte, appelle get_recovery_status (HRV, sommeil, charge, stress, ressenti), puis get_adaptive_recommendation. La réponse est un score sur 100, la séance prévue, et une action concrète : maintenir, réduire l'intensité, basculer en footing, ou repos. Si j'accepte l'ajustement, la séance est modifiée dans le plan, puis la montre est resynchronisée. Si je saute, c'est noté dans le plan.
Voilà pour la vitrine. Passons à ce que j'ai appris en la construisant.
Découverte 1 : la méthodologie doit être lisible, pas codée
La tentation, quand on sort d'un prototype conversationnel, est d'écrire un gros planner.py qui « sait » entraîner. J'ai pris l'autre chemin : les règles vivent en Markdown, dans les skills coaching-rules et coaching-rules-running, et le code Python ne fait que du calcul.
Ça donne des règles qu'on peut lire, contester, versionner. Quelques exemples tirés du fichier de conventions DSL :
- Un footing ne va pas sur la montre. Il se court au ressenti, foulées ou renfo compris. Seules les séances qui portent une qualité ou un bloc d'allure (fractionné, tempo, sortie longue « dont 6 km @ M ») sont poussées. Un workout structuré pour un footing, c'est du bruit au poignet.
- Les échauffements des vraies séances se terminent au bouton lap, pas à une durée ou une distance fixe. Un échauffement de 15 minutes pile qui se termine à 500 m du stade, ce sont des intervalles sur route, entre les voitures.
- Une séance poussée ne s'arrête jamais toute seule. Si le DSL ne finit pas sur une étape ouverte, le builder ajoute un retour au calme terminé au bouton lap. La montre attend que je décide que c'est fini.
- Échauffement minimum 15 minutes sur toute séance de qualité. Jamais moins.
- Fenêtre d'allure Garmin = cible coaching ± 5 s/km, pour que la montre sonne quand ça compte et pas à chaque virage.
Chacune de ces règles est née d'une séance ratée. Dans l'épisode 1, elles vivaient dans un skill fourre-tout. Ici, elles sont découpées, chargées à la demande, et un test vérifie que chaque skill respecte le format standard et que chaque référence pointe vers un fichier qui existe.
L'avantage inattendu : quand Claude propose quelque chose de bizarre, je peux retrouver la règle qui l'a justifié, ou constater qu'aucune règle ne le justifiait. Le débogage d'un coach IA devient de la lecture de doc.
Reste un risque : que les règles et le code divergent. Si je change le calcul d'une allure sans toucher au skill, la doc ment. Le projet embarque donc deux hooks Claude Code, de petits scripts qui se déclenchent après chaque modification de fichier. Le premier repère qu'un module de coaching vient de changer (charge, périodisation, zones, plugin d'un sport) et rappelle de mettre à jour le guide de règles si le comportement a changé, sans jamais y recopier le code : le skill décrit le principe, le code l'implémente. Le second repère une modification du plan ou de la fiche coureur et rappelle d'écrire dans le journal le pourquoi de la décision. Aucun des deux n'écrit à la place de l'agent : ils rappellent, l'agent décide.
Découverte 2 : un LLM est un mauvais calculateur et un excellent orchestrateur
Un VDOT, ça se calcule avec la formule de Daniels-Gilbert. La charge d'entraînement, c'est une moyenne mobile exponentielle sur 42 et 7 jours. Ce sont des fonctions déterministes. Les demander à un modèle de langage, c'est demander à un chef d'orchestre de jouer tous les instruments.
Tout le calcul est donc en Python pur, sans I/O : charge d'entraînement, récupération et périodisation dans le cœur, VDOT, zones, générateur de plan et prédictions dans le plugin course. Ces modules ne touchent ni Garmin, ni le réseau, ni le disque. Ils concentrent la majorité des tests du projet, qui se comptent en centaines. Les tools MCP sont des enveloppes fines autour.
La règle qui en découle est écrite noir sur blanc dans le skill : ne jamais hardcoder une allure, toujours dériver du VDOT. Quand le VDOT change après une course, toutes les allures du plan bougent en cascade. C'est le genre de garantie qu'une conversation ne peut pas offrir.
Bonus : le générateur de plan encode des garde-fous que je n'ai plus besoin de rappeler. Les plafonds de durée par jour (45 minutes le lundi, garde d'enfant) réduisent réellement les séances générées, et un créneau trop court reçoit un footing plutôt que la séance de qualité. Les prédictions semi et marathon appliquent une pénalité si la charge chronique est trop faible : un VDOT frais avec une base aérobie mince ne promet plus un chrono marathon fantaisiste.
Découverte 3 : les bugs les plus chers n'étaient pas des bugs d'IA
Je m'attendais à me battre contre des hallucinations. Ce qui m'a fait perdre des soirées, ce sont trois bugs de plomberie très humains, dont certains de débutant.
Le serveur connecté qui n'exposait aucun outil. Trois jours après le premier commit, Claude Code affichait le serveur comme connected, mais tools/list renvoyait une liste vide. 32 tools définis, zéro visible. La cause : lancer le serveur via python -m open_coach.server chargeait le module deux fois, une fois comme "__main__", une fois sous son nom canonique quand les tools faisaient from open_coach.server import mcp. Deux instances FastMCP distinctes. Les décorateurs enregistraient sur l'une, main() démarrait l'autre. Le correctif tient en une ligne dans .mcp.json :
"args": ["run", "python", "-c", "from open_coach.server import main; main()"]correction mcp
Le paramètre de contexte non typé. En FastMCP, un tool qui déclare ctx=None sans annotation voit son ctx exposé comme paramètre utilisateur dans le schéma. Claude l'appelle avec None, et tout accès à ctx.lifespan_context explose. Il faut annoter ctx: Context. Ce genre de piège est aujourd'hui documenté dans le AGENTS.md du projet, parce que l'IA le reproduisait à chaque nouveau tool.
Garmin SSO derrière Cloudflare. Garmin limite les tentatives de connexion par compte, pas par IP, avec des verrouillages de 48 heures et plus. Un agent qui « réessaie intelligemment » après un échec est exactement ce qu'il ne faut pas. La stratégie est devenue : cache de token d'abord, jamais de retry SSO, et un script de secours à base de navigateur pour les cas bloqués. La règle « pas de retry SSO pendant un lockout » figure dans les anti-patterns du skill, au même niveau que « pas de VO2max sans renfo ».
Avec le recul, le verrouillage Garmin est sans doute le seul de ces trois bugs que j'aurais aussi rencontré en codant tout à la main. Les deux autres sont des pièges qu'un développeur expérimenté connaît : un module chargé deux fois, un paramètre sans annotation. L'IA les a laissés passer, et moi aussi, faute de relire. Aucun n'aurait été évité par un meilleur prompt. Ils ont été résolus par la même méthode qu'un bug ordinaire : lire les logs, reproduire, isoler.
Découverte 4 : la mémoire d'un agent, c'est de la revue de code
Claude Code dispose d'une mémoire persistante par projet. Je pensais m'en servir pour stocker des préférences. Elle est devenue autre chose : un registre des erreurs de raisonnement, avec la correction associée.
Un exemple qui m'a agacé. Deux sorties le même jour, à 07:54 et 09:45. Claude les a présentées comme un « split matin / après-midi ». Le lendemain, il a appelé mon footing du nom de la séance du plan (« Footing piscine ») au lieu du nom réel de l'activité Garmin. Deux erreurs, un seul mécanisme : un rapprochement implicite entre l'activité réelle et la séance planifiée, sans validation.
La correction n'est pas un prompt. Ce sont quatre règles, écrites dans le AGENTS.md du projet et envoyées par le serveur à chaque client, qui s'appliquent à tout agent, quel que soit le modèle :
- Plusieurs activités le même jour : afficher les heures brutes et calculer l'écart.
- Deux colonnes distinctes, activité réelle et séance planifiée, jusqu'à validation explicite du match.
- Le libellé est le nom Garmin brut, jamais la description du plan.
- Une activité sans correspondance est orpheline, pas « probablement la séance de mardi ».
Même logique côté athlète : le skill coaching-rules maintient un journal append-only où chaque décision de coaching porte sa date, un tag, et surtout le pourquoi. La règle méta est explicite : les insights du journal priment sur les principes universels. Si le journal dit que j'ai raté deux courses en partant trop vite, la règle « pacing strict » devient non négociable pour moi, plus que pour un autre coureur.
Découverte 5 : même un projet perso exige une frontière données / code
Je voulais pouvoir montrer le code à un collègue, le faire relire, le cloner sur une autre machine, et un jour le publier. Problème : un coach personnel est, par construction, plein de données personnelles, et de santé. Mon VDOT, mes courses cibles avec leurs dates, mes tendons fragiles, mon format de gel préféré, le créneau du lundi.
La règle est devenue une politique écrite dans CONTRIBUTING.md : aucune donnée personnelle dans le code versionné, jamais. Le dépôt ne connaît pas d'« athlète par défaut ». Il livre des templates avec des placeholders. Un script d'onboarding les copie dans des emplacements ignorés par Git, où on renseigne ses propres valeurs. Les skills lisent ces fichiers au démarrage, avec un repli générique si absents.
Et parce qu'une politique sans contrôle est un vœu pieux, un script d'audit tourne en pre-commit et en CI. Il cherche des marqueurs de fuite : chemins personnels, adresses e-mail, identifiants de dossier Drive, secrets en clair, plus une liste de motifs personnels injectée par variable d'environnement et jamais commitée. Chez moi, un de mes noms de course dans un fichier versionné fait échouer le commit.
Ce n'est pas la partie glamour. C'est celle qui permet de montrer le code sans montrer sa vie. C'est aussi elle qui a rendu l'ouverture possible : le jour où j'ai rendu le dépôt public, il n'y avait rien à nettoyer.
Découverte 6 : la dette générée par l'IA est silencieuse
Le dépôt a été écrit à une large majorité par Claude, sous ma direction. En septembre, j'ai lancé un audit complet du code. Ce que j'ai trouvé m'a fait réfléchir :
- Des fonctionnalités dormantes : codées, testées parfois, mais jamais branchées. Un module d'exceptions livré et jamais importé. Une contrainte de durée acceptée par l'API mais ignorée par le générateur.
- Du code mort que personne n'avait supprimé, parce que personne n'avait relu.
- Trois contrats d'erreur différents selon les tools : certains levaient une exception, d'autres renvoyaient une liste, d'autres un dict. Un agent qui appelle ces tools doit gérer les trois.
- Une dépendance de dev qui n'était installée par personne. La CI tournait, mais sur du vide.
La remédiation a pris deux commits denses et ajouté plus de 150 tests. Rien de tout cela n'était visible en utilisation quotidienne. Le coach fonctionnait. Il fonctionnait sur des fondations qu'aucun humain n'avait inspectées.
La leçon rejoint celle de mon article sur la data stack souveraine : quand on ne comprend pas chaque brique, on ne possède pas le système. Avec l'IA, le risque est inversé mais identique. Le SaaS est une boîte noire qu'on n'a pas écrite. Le code généré est une boîte noire qu'on a cru écrire.
Découverte 7 : un outil qui devine est pire qu'un outil qui refuse
Le 10 septembre, mon plan disait « 10 km dont 15 min @ M ». Le tool de synchronisation l'a poussé sur la montre comme un seul bloc de 7,5 km à allure marathon, précédé d'un échauffement de 2 km à distance fixe. Aucune erreur, aucun avertissement. La séance était valide, jolie, et fausse.
En ouvrant le code, j'ai trouvé une heuristique que je n'avais jamais relue : tempo = 2 km d'échauffement + (total − 3,5 km) à l'allure cible + 1,5 km de retour au calme. Pour un footing : 1 km + bloc + 1 km. Les fractionnés ne matchaient jamais, parce que le générateur écrivait intervals et le convertisseur cherchait interval. Trois formes, une seule sortie possible : une structure inventée, qui ressemblait à une séance.
Le correctif n'a pas été une heuristique plus fine. C'est un parseur de descriptions en Python pur, qui lit ce que dit le plan (3×1 km @ T r 2', 12 km dont 25 min @ M), résout les lettres d'allure depuis le VDOT, et refuse tout ce qu'il ne comprend pas. Le tool remonte alors la séance dans une liste not_converted avec la raison, et c'est à moi, ou au coach en conversation, de la construire à la main.
C'est la leçon de l'épisode 1 poussée un cran plus loin. Le DSL contraignait ce que Claude pouvait produire. Le parseur contraint ce que le système accepte de pousser sur ma montre. Entre une séance approximative sans alerte et un refus explicite, le refus est le seul comportement dont je peux me servir.
Découverte 8 : l'IA rend la roue trop facile à réinventer
Pour parler à Garmin Connect, le projet s'appuie sur python-garminconnect, la bibliothèque Python maintenue depuis 2020 par Ron (cyberjunky), sous licence MIT. Plus de 3 000 étoiles sur GitHub : c'est elle qui fait le travail ingrat de suivre une API que Garmin ne documente pas pour les particuliers, et sans elle ce projet n'existerait pas.
En avril, six semaines avant le premier commit, j'ai buté sur un manque de cette bibliothèque : on pouvait créer et planifier un workout, mais ni le supprimer ni le déprogrammer. Or l'API Garmin ne sait pas modifier une séance en place. Le seul motif possible est supprimer puis recréer. Sans suppression, pas de plan qui bouge.
Claude m'a proposé la solution en trente secondes : un appel HTTP direct vers l'endpoint interne, cinq lignes, dans mon propre code. Ça aurait marché. Ça aurait aussi produit un morceau de client Garmin maison, non testé, à maintenir moi seul, invisible pour tous ceux qui ont le même besoin. Exactement la dette silencieuse de la découverte 6, avant même d'avoir écrit la première ligne du projet.
J'ai fait l'inverse : une issue sur le dépôt python-garminconnect, avec le cas d'usage, le motif « delete + recreate », et la signature des deux méthodes qui manquaient : delete_workout() pour supprimer une séance, unschedule_workout() pour la retirer du calendrier. Ron les a implémentées et publiées l'après-midi même, dans la version 0.3.0. Mon projet dépend de cette version, et pas d'une ligne de plus. Depuis, d'autres contributeurs ont corrigé et référencé ces méthodes : elles vivent sans moi.
Je n'ai pas écrit une ligne de cette fonctionnalité. J'ai écrit une demande précise. C'est la forme de contribution la moins spectaculaire et, avec un assistant qui sait générer n'importe quel contournement local, celle qui demande le plus de retenue. La roue est déjà là. Le réflexe à entraîner n'est plus « je peux le coder », c'est « à qui ça manque aussi ».
Découverte 9 : un coach qui ne parle qu'à un seul agent n'est qu'à moitié ouvert
Tout fonctionnait dans Claude Code, et pour cause : Claude Code lisait le CLAUDE.md, chargeait les skills et exécutait les hooks du projet. Mais en relisant l'architecture, un constat s'imposait : un autre client MCP branché sur le même serveur n'aurait reçu que ses tools, et rien d'autre. Pas les règles de coaching, pas les workflows, pas la consigne « après chaque modification du plan, resynchronise la montre ». Le code était ouvert. Le coach, lui, ne l'était pas.
Le principe qui en est sorti : tout ce qu'un agent doit savoir voyage par le serveur lui-même, jamais par un fichier propre à un client. Concrètement :
- Les règles de fonctionnement partent dans les instructions MCP, envoyées à chaque client dès la connexion : lire le contexte d'abord, les règles d'analyse des activités, la synchro montre, la sécurité du compte Garmin.
- Les skills suivent un standard ouvert. Ils vivent dans .agents/skills/, au format Agent Skills, que Codex, Gemini CLI, Cursor ou Copilot lisent nativement. Claude Code y accède par un lien symbolique. Pour les clients qui ne lisent pas les skills, le serveur les sert lui-même : en ressources skill://, en prompts MCP, et via un tool get_coaching_guide dont la description contient le catalogue des guides.
- Les consignes arrivent au moment où elles s'appliquent. Un hook ne tourne que dans Claude Code. Alors les tools qui modifient le plan renvoient des next_steps dans leur réponse : synchroniser la montre, écrire dans le journal, lancer la synchro Drive.
- Chaque ressource clé a son tool miroir, parce que beaucoup de clients ignorent les ressources MCP.
- Les petits modèles sont servis aussi : des schémas typés plutôt que du JSON dans une chaîne, et des réponses compactes par défaut pour les petites fenêtres de contexte.
- CLAUDE.md est devenu AGENTS.md, le fichier que les autres agents cherchent. CLAUDE.md l'importe et n'ajoute que ce qui est propre à Claude Code.
Comme pour Garmin et pour la course, une consigne ne suffit pas à garder le cap : un test échoue si un workflow n'a pas son prompt, si les instructions perdent une règle clé, ou si un paramètre structuré ne publie plus son schéma.
Claude Code et les autres : pas le même confort
Portable ne veut pas dire identique. Chaque famille de clients reçoit le coach différemment :
- Claude Code reste le client de référence. Il charge les skills nativement, exécute les hooks (le rappel d'écrire dans le journal après une modification du plan, celui de mettre à jour les règles quand le code de coaching change), et garde une mémoire persistante du projet. C'est là que tout a été construit et utilisé au quotidien.
- Les agents de code, comme Codex, Cursor, Gemini CLI ou Copilot, lisent AGENTS.md et les skills de .agents/skills/ dès que le dépôt est ouvert. Ils n'ont pas les hooks : les consignes leur arrivent par les next_steps des tools. Le dépôt fournit la configuration de Cursor et de Gemini CLI, et la documentation couvre Codex et VS Code.
- Les clients de chat, comme Claude Desktop, n'ont pas accès aux fichiers : pas de fiche coureur ni de journal Markdown. Ils travaillent uniquement depuis le contexte que renvoie le serveur, ce qui couvre l'essentiel (profil, objectifs, contraintes, plan, retours récents).
- Les modèles locaux, via Ollama ou LM Studio derrière un client MCP, dépendent surtout de la qualité de leur appel de tools. Les schémas complets et les réponses compactes sont là pour eux.
Et une limite vaut pour tout le monde : aucun client n'oblige le modèle à charger un guide. Le modèle choisit à partir du catalogue. Le mettre dans les instructions et dans la description du tool rend le chargement bien plus probable, mais un modèle plus faible peut encore sauter la règle. Quand ça compte, mieux vaut démarrer par le prompt du workflow (/plan-training, /daily-check).
Pour être clair : tout cela est construit à partir des standards et de la documentation des clients, et couvert par des tests côté serveur. Mais hors de Claude Code, presque tout reste à tester et à découvrir. Est-ce que Gemini choisit le bon guide sans qu'on le lui demande ? Est-ce que Codex enchaîne les next_steps ? Est-ce qu'un modèle local tient le schéma complet d'un plan d'entraînement ? Je n'ai pas encore les réponses, et c'est typiquement le genre de retour que j'espère de la communauté.
C'est la même leçon, appliquée une troisième fois. L'appareil, le sport, l'agent : dès qu'une brique dépend d'un fournisseur, elle passe derrière une interface neutre, et un test l'y maintient. Ce qui reste propre à Claude Code dans le projet tient en quelques lignes, et c'est voulu.
Ce qui manque encore
Par honnêteté, la liste des trous :
- L'authentification Garmin reste fragile. Pas d'API officielle pour un particulier, donc un client non officiel et un cache de token. Strava en secours atténue, ne résout pas.
- Une seule marque. La couche provider est prête, mais Garmin reste le seul provider implémenté (epic #5). COROS, Polar, Suunto : chaque marque est un provider à écrire, et c'est typiquement là qu'une contribution aurait le plus d'impact. Et si l'une de ces marques veut me prêter une montre pour que je la teste et l'intègre, ce sera avec grand plaisir !
- Un seul sport. L'architecture est prête pour le vélo et la natation, avec la liste des étapes pour ajouter un sport, mais seule la course est écrite. Un coach triathlon reste à construire.
- Pas d'unités impériales. Kilomètres et min/km partout : un coureur qui pense en miles ne s'y retrouve pas encore. Le chantier est découpé en sous-issues indépendantes (epic #11).
- Le stockage est du JSON à plat. Suffisant pour une carrière de coureur amateur, indéfendable au-delà d'un utilisateur. Au moins, il sait désormais migrer tout seul quand son format change.
- Pas encore éprouvé hors de Claude Code. Le serveur transporte désormais ses règles et ses guides vers n'importe quel client MCP, mais je ne l'utilise au quotidien que dans Claude Code. Les autres clients et les autres modèles restent à tester : les retours sont les bienvenus (epic #6).
- Le coût en tokens n'a pas baissé. Il est mieux dépensé, parce que le contexte lu au démarrage est ciblé et que le calcul est sorti du modèle. Mais une session de planification reste chère.
- Le temps. Je développe ce projet sur mon temps libre. Les évolutions avancent à ce rythme-là, et c'est aussi pour ça que chaque contribution compte.
- La discipline. Toujours pas de tool MCP pour ça. J'ai vérifié.
Contribuer pendant le mois de l'open source
Ouvrir un dépôt ne suffit pas à le rendre contribuable. Avant la publication, j'ai donc préparé le terrain :
- Des issues prêtes à prendre. Les gros chantiers sont des epics découpées en sous-issues autonomes, chacune avec son périmètre et sa liste « terminé quand ». Les plus accessibles portent le label good first issue, les autres help wanted.
- Trois portes d'entrée : une nouvelle montre (COROS, Suunto, Polar, Apple Watch…), les unités impériales, et des retours d'usage avec d'autres clients MCP et d'autres modèles. Ce dernier ne demande pas une ligne de code : brancher le serveur sur son client et raconter ce qui casse est déjà une contribution.
- Un cadre clair : guide de contribution, code de conduite, politique de sécurité, modèles d'issue et de pull request. La CI lance les mêmes vérifications qu'en local, audit des données personnelles compris.
La méthodologie compte autant que le code. Un entraîneur qui conteste une règle de coaching-rules, sources à l'appui, fait avancer le coach plus sûrement qu'une nouvelle fonctionnalité.
Ce que je retiens
Dans l'épisode 1, j'avais découvert que la contrainte (un DSL) battait la confiance (un prompt). Cet épisode généralise la leçon à tout le système.
Le prototype conversationnel avait une intelligence diffuse : tout était dans le contexte, rien n'était vérifiable. Le projet a une intelligence localisée : les règles dans des fichiers lisibles, le calcul dans des fonctions testées, les erreurs passées dans une mémoire structurée, les données personnelles derrière une frontière auditée. Claude orchestre. Il ne détient plus rien, et il n'est même plus indispensable : les règles voyagent avec le serveur, vers n'importe quel agent.
Ce n'est pas plus « intelligent ». C'est plus inspectable. Et un coach qu'on peut inspecter est le seul à qui on peut confier une saison.
L'ouvrir était la suite logique. Un coach que je suis le seul à pouvoir inspecter ne l'est qu'à moitié. Désormais, n'importe quel coureur, ou n'importe quel entraîneur, peut aller lire la règle qui a produit sa séance, la contester, et proposer mieux.
Si vous avez un prototype IA qui marche à 95 % et que vous hésitez à le transformer en projet : faites-le, mais pas pour le rendre plus puissant. Faites-le pour savoir, à chaque recommandation, quelle règle l'a produite.
Le code est sur GitHub, en logiciel libre sous licence AGPL-3.0 : d474b3r9/open-coach. Projet personnel, développé sur mon temps libre, il est ouvert aux contributions : méthodologie de coaching, nouvelles montres, traductions, code. Le guide de contribution explique par où commencer, et un CLA se signe une fois, à la première pull request. Le dépôt ne contient aucune donnée d'athlète, y compris les miennes. Et si cet outil peut rendre la vie d'autres athlètes un peu plus simple, j'en serai vraiment content.