Cachez donc ce prompt que je ne saurais voir !
(Un développeur qui a un peu halluciné)
Le prompt caching, c'est du recyclage de prompt : on ne le jette pas, on le réutilise pour nos requêtes ultérieures !
Le fonctionnement
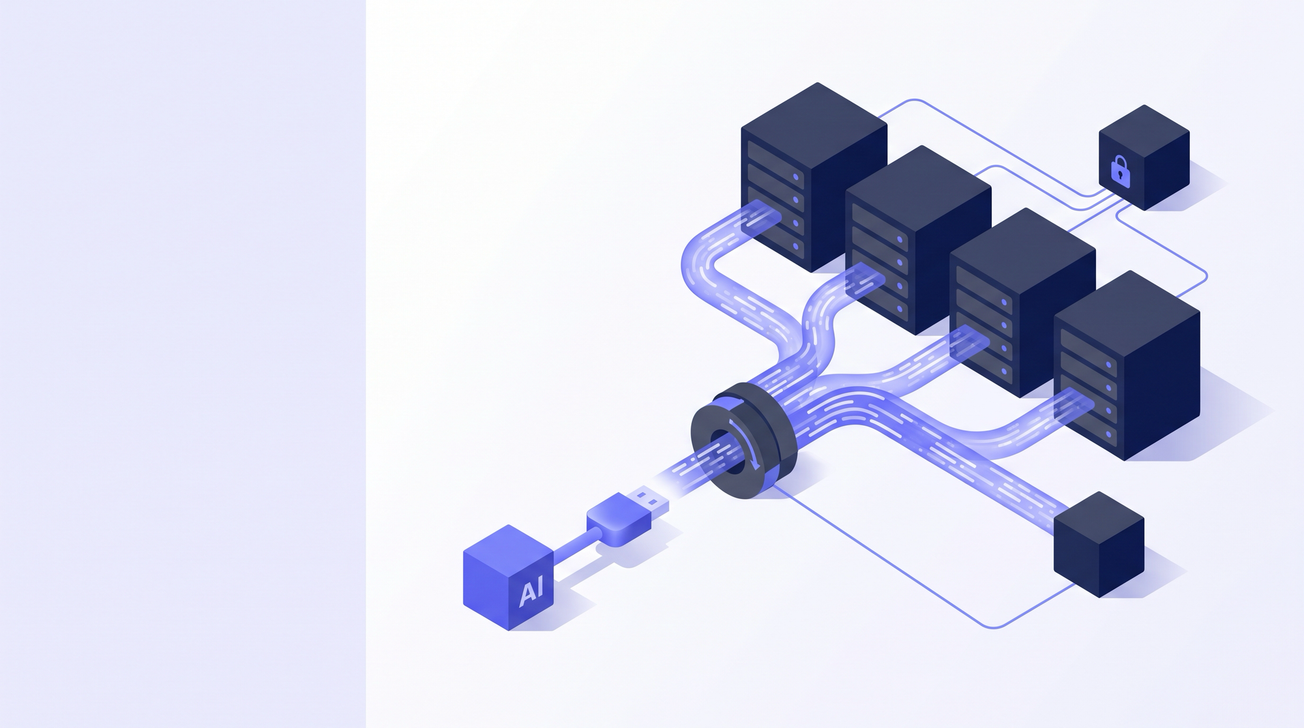
Dans notre domaine, cacher signifie "garder sous la main". Le prompt caching est donc littéralement "garder du prompt sous la main". La partie conservée (on emploiera le terme "cachée" dans le reste de l'article) est un préfixe de prompt. Il est possible de déterminer finement les parties de prompts à cacher en plaçant des points de contrôle breakpoint. Ces parties n'ont alors pas besoin d'être retraitées par le LLM qui les conserve dans sa mémoire.
Lorsqu'une requête est envoyée, les éléments suivants se chargent dans cet ordre :
Tools -> system -> messages
Cela signifie qu'un breakpoint placé après le message permettra de mettre en cache toute cette chaîne.
Un mode automatique est également possible et permet de cacher la conversation au fur et à mesure de son avancement.
⚠️ Attention, le cache peut être invalidé de deux manières différentes :
- Si le préfixe change, alors le préfixe et tous les blocs suivants qui sont aussi cachés sont invalidés.
- Après une certaine durée d'inactivité (par défaut, 5 minutes).
L'utilité
Pourquoi c'est utile ? Claude se débrouille comme il veut, du moment que j'ai ma réponse ! Pourquoi je m'embêterais avec ça ?
Trois réponses :
💰 Économies : Le cache n'est facturé que 10% de la valeur du token d'entrée (et encore, il s'agit d'un max ! Sur Claude Fable 5.1 on tombe à 2,5% !)
🚄Performances : On gagne du temps ! Ce qui est fait n'est plus à faire
🌱 Écologie : Un traitement qui n'est plus à faire, c'est autant de ressources qu'on n'utilise pas
Comment le mettre en place
Mise en place sur Claude Code
Rien à faire dans ce cas-là. Le prompt caching est automatique. Pour constater son effet, la commande /cost permet d'observer le coût de la session et de voir la part facturée au service plein et la part qui a été facturée depuis le cache.
Attention, si vous êtes du genre à switcher tout le temps de modèle sur une même session, vous cassez ce prompt caching.
Mise en place dans un code qui manipule un modèle
Lorsque vous utilisez une API, le caching n'est plus automatique par défaut. C'est au développeur de gérer son cache manuellement ou de spécifier qu'il souhaite utiliser un cache automatique.
Voici un exemple de code permettant de fixer un breakpoint suite à un bloc system
client = anthropic.Anthropic()

# Fire this before users arrive to warm the shared system-prompt cache.
prewarm = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=0,
    system=[
        {
            "type": "text",
            "text": "You are an expert software engineer with deep knowledge of distributed systems...",
            "cache_control": {"type": "ephemeral"},
        }
    ],
    messages=[{"role": "user", "content": "warmup"}],
)
print(prewarm.stop_reason)  # "max_tokens"
print(prewarm.content)  # []
print(prewarm.usage)
⚠️ Points de vigilance à l'implémentation
- Ordre du code : Construire le contenu stable avant le contenu variable, dans le même appel.
- Déterminisme : Sérialiser les objets avec des clés triées. Un JSON dont l'ordre évolue casse le cache.
Sources