Il y a des projets que l'on décide de commencer.
Et puis il y a ceux qui finissent par s'imposer progressivement, article après article, talk après talk, expérimentation après expérimentation, jusqu'au jour où l'on réalise qu'ils étaient en réalité la conséquence assez logique de tout ce que l'on faisait avant.
Goblin fait partie de la seconde catégorie.
Aujourd'hui, Goblin est une extension open source de Quarkus dédiée au Chaos Engineering. Elle permet d'injecter de la latence, des exceptions, des erreurs HTTP ou encore de simuler la dégradation d'une dépendance dans une application en cours d'exécution. Le tout sans modifier le code de l'application et, surtout, avec une philosophie très claire : provoquer volontairement des situations difficiles afin de vérifier que les mécanismes de résilience que nous avons mis en place font réellement leur travail.
Mais Goblin n'est pas né d'une idée du genre
« tiens, je vais développer une extension Quarkus ».
L'idée est beaucoup plus ancienne.
Elle remonte à une succession d'articles, de conférences et de réflexions autour d'un même sujet qui m'accompagne depuis plusieurs années : comment savoir si notre résilience fonctionne vraiment ?
Et, quelque part en chemin, une seconde question est venue s'ajouter à la première : pourquoi Quarkus ne disposait-il pas encore d'un équivalent applicatif à Chaos Monkey ?
Pour comprendre comment un gobelin a fini par apparaître dans l'écosystème Quarkus, il faut donc revenir quelques années en arrière.
Tout a commencé avec le Chaos Engineering
Il y a quelques années, j'ai commencé à écrire autour du Chaos Engineering.
Ce qui m'attirait dans cette discipline était assez simple : nous passons énormément de temps à prévoir les pannes, mais beaucoup moins de temps à vérifier que nos applications se comportent effectivement comme nous l'avons prévu lorsque ces pannes surviennent.
Dans une application moderne, nous disposons pourtant d'un arsenal impressionnant pour gérer les défaillances.
Nous ajoutons des timeouts pour éviter qu'un appel ne reste bloqué indéfiniment. Nous utilisons des retries pour absorber certaines erreurs transitoires. Nous ajoutons des fallbacks lorsqu'une réponse de secours est possible. Nous mettons en place des circuit breakers pour éviter qu'une dépendance défaillante ne finisse par contaminer l'ensemble de notre application.
Tout cela est parfaitement légitime. Ce sont même des mécanismes indispensables dès lors qu'une application commence à dépendre d'autres services, de bases de données, de brokers ou de systèmes externes.
Mais il existe un piège.
Une configuration de résilience reste avant tout une intention.
Prenons un exemple très simple. Nous avons un appel qui peut prendre du temps et nous décidons de le protéger avec un timeout et un fallback :
@Timeout(1)
@Fallback(fallbackMethod = "fallback")
public Response call() {
    // ...
}
À première vue, nous avons fait ce qu'il fallait.
Mais que savons-nous réellement ?
- Savons-nous que l'appel dépasse effectivement le délai attendu ?
- Savons-nous que le timeout interrompt bien l'exécution ?
- Savons-nous que le fallback est ensuite invoqué ?
- Savons-nous ce qui se passe si l'appel échoue après avoir été particulièrement lent ?
Et si le mécanisme de retry est également présent, savons-nous combien de fois l'appel est réellement rejoué dans ce scénario ?
Nous pouvons évidemment écrire des tests pour vérifier chacun de ces cas. Mais c'est précisément là que le Chaos Engineering devient intéressant.
Plutôt que de simplement vérifier que notre code correspond à ce que nous pensons qu'il devrait faire, nous pouvons provoquer la situation problématique et observer le comportement réel de l'application.
- Une dépendance devient indisponible.
- Une requête devient beaucoup plus lente que prévu.
- Une erreur apparaît de manière intermittente.
- Un service commence à répondre avec des
503.
Et nous regardons ce que fait réellement notre système.
C'est cette approche expérimentale qui m'a progressivement intéressé dans le Chaos Engineering. Il ne s'agit pas simplement de casser des choses pour le plaisir de les casser. Le chaos n'est intéressant que s'il permet de répondre à une question.
Que se passe-t-il si cette dépendance tombe ?
Que se passe-t-il si elle devient lente ?
Est-ce que mon timeout se déclenche ?
Est-ce que mon fallback fonctionne ?
Est-ce que mon retry ne fait pas finalement plus de mal que de bien ?
À partir de là, le Chaos Engineering devient une manière de confronter les hypothèses d'architecture à la réalité.
J'ai commencé à écrire plusieurs articles autour de cette approche, en partant d'abord de ce qui se cache derrière l'idée d'introduire volontairement du chaos dans une application. Mais assez rapidement, écrire sur le sujet ne me suffisait plus : je voulais également pouvoir le montrer.
Du clavier à la scène
Le sujet m'a ensuite accompagné jusque sur scène avec plusieurs talks autour de Chaos Monkey et Spring Boot, dans la continuité de ce que j'avais commencé à écrire sur le sujet.
Chaos Monkey m'intéressait justement parce qu'il permettait de passer de la théorie à quelque chose de beaucoup plus concret : au lieu de simplement expliquer que notre application devait être capable de survivre à une panne, nous pouvions provoquer cette panne et regarder le résultat.
C'est une différence assez importante. Faire tomber une application est relativement facile, il suffit parfois de supprimer une dépendance, d'arrêter un service ou de provoquer une exception. Mais ce n'est pas vraiment cela qui m'intéressait. Le véritable sujet était ce qui venait après la panne :
- Si un service devient lent, mon timeout intervient-il au bon moment ?
- Si l'appel échoue, le fallback prend-il correctement le relais ?
- Si une erreur est temporaire, le retry permet-il réellement de récupérer la situation ?
- Et si plusieurs mécanismes sont combinés, est-ce bien le mécanisme que je pensais qui intervient en premier ?
Chaos Monkey fournissait alors une manière très concrète d'expérimenter ces questions dans l'écosystème Spring Boot.
C'est aussi ce qui rendait le sujet particulièrement intéressant à présenter dans un talk. On pouvait commencer avec une application qui semblait parfaitement fonctionnelle, montrer les mécanismes de résilience présents dans le code, puis introduire volontairement une perturbation.
Et soudain, le discours théorique devenait une observation.
On ne disait plus :
« Normalement, le fallback devrait être appelé. »
On pouvait réellement le vérifier.
Cette expérience m'a conforté dans une idée qui allait continuer à me suivre : la résilience ne devrait pas seulement être déclarée, elle devrait être éprouvée.
À cette époque, mon terrain de jeu était principalement Spring Boot. Chaos Monkey était donc une réponse naturelle pour expérimenter cette approche.
Mais au fil du temps, mes sujets ont évolué. Et une autre technologie a pris une place de plus en plus importante dans mes articles et mes expérimentations : Quarkus.
La résilience applicative : construire les défenses
En parallèle de mes travaux autour du Chaos Engineering, j'ai continué à m'intéresser à la résilience applicative elle-même. Parce qu'il ne suffit évidemment pas de provoquer des pannes : encore faut-il construire une application capable d'y répondre.
Dès qu'une application communique avec des systèmes externes, nous devons accepter une réalité assez désagréable : nous ne contrôlons pas tout ce qui se trouve de l'autre côté de notre appel. Le réseau peut être lent, une dépendance peut ne plus répondre, un broker peut rencontrer des problèmes. C'est pour cela que des mécanismes comme les timeouts, les retries, les fallbacks et les circuit breakers sont devenus des outils indispensables.
Dans l'écosystème Quarkus, tout l'arsenal était déjà là. Avec MicroProfile Fault Tolerance, on dispose de @Timeout, @Retry, @Fallback et des circuit breakers. Et pour les applications réactives, Mutiny apporte également ses propres mécanismes permettant de composer des traitements et de gérer leurs erreurs ou leurs timeouts. Le côté défensif ne posait pas vraiment de problème.
 Erwan Le Tutour
Mais un @Retry dans le code ne prouve pas que le retry fonctionne. Un @Timeout ne prouve pas que le timeout se déclenche dans les conditions prévues. Un @Fallback ne prouve pas que le fallback sera effectivement utilisé lorsque la dépendance disparaîtra.
La présence du mécanisme n'est pas la preuve de son efficacité.
C'est là que les deux sujets, résilience et Chaos Engineering, ont commencé à se rejoindre naturellement. D'un côté, les mécanismes qui doivent protéger l'application. De l'autre, les expériences qui permettent de vérifier leur comportement. L'un sans l'autre laisse une zone d'incertitude, une certitude que l'on peut aussi éprouver en mettant l'application sous charge.
 Erwan Le Tutour
Puis vint Quarkus
Pendant ce temps, Quarkus prenait une place de plus en plus importante dans mes travaux.
J'ai commencé à écrire régulièrement autour de son écosystème et de ses différentes possibilités : REST, Kafka, GraphQL, les annotations, les extensions et, plus généralement, tout ce qui permet de construire des applications Java modernes avec Quarkus.
Plus je travaillais avec cet écosystème, plus je retrouvais les mêmes problématiques de résilience que celles que j'avais rencontrées auparavant.
Le Chaos Engineering existe… mais pas au niveau applicatif
Quand on cherche à introduire du chaos dans une application Quarkus, on découvre rapidement un paysage fragmenté.
D'un côté, il existe d'excellents outils de Chaos Engineering au niveau de l'infrastructure. Chaos Mesh, Litmus ou encore Pumba permettent de tuer des pods, de provoquer des partitions réseau ou de simuler des pannes disque. Ces outils sont puissants, mais ils opèrent à côté de l'application, pas dedans : ils ne vérifient pas le comportement applicatif. Quand un pod est tué, l'application ne teste pas son @Timeout, elle subit juste une coupure réseau.
De l'autre côté, l'écosystème Quarkus propose quelques solutions qui s'en rapprochent, mais avec des compromis importants :
- quarkus-chaos-monkey propose une extension Quarkus pour injecter de la latence, des exceptions ou des erreurs HTTP. Mais il repose sur des annotations (
@ChaosMonkey) qu'il faut placer sur chaque endpoint ciblé. C'est un Chaos Engineering intrusif : il faut modifier le code de l'application pour pouvoir le perturber. Et surtout, il est possible de l'activer en production via la propriétéquarkus.chaos-monkey.always-enabled=true, ce qui n'est pas sans risque. - macstab-chaos-jvm-agent utilise l'instrumentation bytecode via Byte Buddy pour intercepter des appels JDK au niveau du processus JVM. C'est une approche très puissante et très bas niveau (62 points d'interception sur le JDK), mais c'est aussi une approche générique qui ne comprend pas nativement le modèle REST de Quarkus ni sa Dev UI.
- WireMock et Testcontainers permettent de simuler des services externes défaillants, mais ils nécessitent de mettre en place un environnement de test spécifique, ce qui est idéal pour les tests automatisés, mais moins adapté à l'expérimentation en direct avec l'application en cours de développement.
En résumé, l'écosystème disposait déjà de mécanismes de résilience (SmallRye Fault Tolerance, Mutiny) et d'outils de chaos au niveau infrastructure. Mais il manquait un chaînon : un outil capable de perturber les requêtes REST de l'application elle-même, sans modifier le code, directement dans l'environnement de développement.
Ce chaînon manquant a un nom.
Le trou dans la raquette
Concrètement, ce trou se manifestait par une question très simple : si je voulais vérifier un @Timeout, il fallait provoquer une opération suffisamment lente. Si je voulais vérifier un @Fallback, il fallait provoquer une erreur. Si je voulais vérifier un retry, il fallait reproduire une défaillance suffisamment réaliste pour observer les nouvelles tentatives.
Évidemment, plusieurs solutions étaient possibles :
- écrire un test d'intégration spécifique,
- utiliser des mocks,
- modifier temporairement mon code pour introduire un
Thread.sleep()ou une exception, - construire un environnement externe capable de simuler une panne réseau ou une dépendance indisponible.
Mais aucune de ces solutions ne me donnait exactement ce que je cherchais.
Je voulais retrouver la simplicité de l'expérimentation avec Chaos Monkey : lancer mon application, provoquer volontairement un problème et observer sa réaction.
Sans ajouter une annotation de chaos sur chaque endpoint, sans modifier temporairement le code métier, sans écrire un test spécifique pour chaque combinaison de panne, et surtout sans avoir besoin de transformer l'application en véritable laboratoire de fortune à chaque fois que je voulais vérifier un mécanisme de résilience.
C'est ce constat que j'avais d'ailleurs laissé en suspens à la fin du guide de résilience applicative : l'écosystème Quarkus n'avait tout simplement pas encore d'équivalent à Chaos Monkey, ce qui m'avait forcé à coder le chaos à la main plutôt que de l'importer depuis une dépendance existante. Ce « pas encore » n'était pas anodin.
 Erwan Le Tutour
L'idée devenait alors assez évidente.
Il manquait à Quarkus une sorte de Chaos Monkey applicatif.
Pas un outil destiné à tuer des pods ou à partitionner un réseau : il existe déjà d'excellents outils pour ce genre de Chaos Engineering au niveau de l'infrastructure. Je cherchais quelque chose de beaucoup plus proche de mon expérience avec Spring Boot : un outil capable de venir perturber les requêtes de l'application elle-même, capable de :
- lui injecter de la latence,
- provoquer une exception,
- retourner un
503,
et de pouvoir faire tout cela en développement, rapidement, de manière contrôlée et réversible.
À ce stade, la question n'était plus vraiment « est-ce qu'un tel outil serait utile ? ».
La question devenait :
« pourquoi ne pas le faire ? »
Alors j'ai forgé Goblin
C'est ainsi que Goblin a commencé à prendre forme.
L'objectif initial était volontairement simple : apporter à Quarkus un outil de Chaos Engineering orienté développement, capable de provoquer des défaillances réalistes et de permettre au développeur d'observer la réaction de son application.
Je ne voulais pas d'un système qui oblige à modifier le code métier, ni multiplier les annotations du genre @ChaosLatency ou @ChaosException sur les endpoints : le code de l'application devait rester exactement ce qu'il était.
Le chaos devait être une préoccupation extérieure, activable lorsque l'on souhaite expérimenter et invisible lorsque l'on n'en a pas besoin.
Une architecture pensée pour l'extériorité
Goblin s'est naturellement installé au niveau des filtres JAX-RS. Un ContainerRequestFilter global s'intercale sur les requêtes entrantes, sans aucun couplage avec le code métier : il observe simplement la requête qui traverse la couche REST, avant même qu'elle n'atteigne l'endpoint.
Pour chaque requête entrante, le filtre suit un processus en plusieurs étapes :
- Activation : le chaos est-il actif ?
- Ciblage : cette requête doit-elle être affectée ? (basé sur un pourcentage aléatoire)
- Éligibilité : l'endpoint est-il dans le scope ? (filtres par package ou par annotation)
- Exécution : tous les assauts activés sont appliqués dans l'ordre.
C'est l'AssaultEngine, un bean @ApplicationScoped, qui orchestre le tout. Depuis la première version, deux autres filtres sont venus compléter le dispositif : un ContainerResponseFilter pour abîmer les réponses au moment où elles sortent, et un ClientRequestFilter pour s'attaquer aux appels sortants.
Six types d'assauts
Au départ, Goblin ne savait faire que quatre choses. Il en sait maintenant six, activables indépendamment ou en combinaison.
Latence : injecte un délai aléatoire (entre un min et un max configurables en millisecondes) avant le traitement de la requête. Idéal pour tester les timeouts, les circuit breakers et les mécanismes de retry.
Exception : lève une exception configurable (classe et message) avant l'exécution de l'endpoint. L'endpoint n'est jamais appelé. La classe doit étendre RuntimeException et exposer un constructeur prenant un String, sinon Goblin logue une erreur et retombe sur une RuntimeException.
Statut HTTP : retourne un code de statut configurable (par défaut 503) sans exécuter l'endpoint. Utile pour simuler un service indisponible.
Dégradation de dépendance : retourne un 503 avec le message « Dependency unavailable ». Conçu spécifiquement pour tester les @Fallback et les @Retry sur les appels sortants.
Et puis deux nouveaux venus, qui ne cassent plus la requête mais abîment la réponse.
Corps de réponse (RESPONSE_BODY) : réécrit l'entité renvoyée par l'endpoint. Deux modes existent. TRUNCATE ne garde que les premiers X % du corps : un JSON tronqué à 50 % n'est plus un JSON valide, et votre client strict devrait s'en plaindre. INFLATE rembourre le corps avec un marqueur pour atteindre X % de la taille d'origine (typiquement plus de 100 %), alors que le Content-Length continue d'annoncer l'ancienne taille. C'est le genre de petit sabotage qui fait réfléchir les proxies et les parseurs qui vérifient les longueurs.
quarkus.goblin.assault.type=RESPONSE_BODY
quarkus.goblin.assault.body.mode=truncate
quarkus.goblin.assault.body.percentage=50
En-têtes de réponse (RESPONSE_HEADER) : ajoute, remplace ou supprime des en-têtes sur la réponse émise. Pratique pour vérifier ce que votre client suppose (à tort) sur le cache, le CORS, la sécurité ou la négociation de contenu, sans toucher au code.
quarkus.goblin.assault.type=RESPONSE_HEADER
quarkus.goblin.assault.headers.Cache-Control.action=set
quarkus.goblin.assault.headers.Cache-Control.value=no-store
quarkus.goblin.assault.headers.Content-Type.action=remove
Et surtout, plusieurs types peuvent être actifs simultanément sur la même requête. La latence est toujours appliquée en premier, suivie de l'exception ou du statut HTTP. Les assauts sur le corps et les en-têtes s'appliquent à la sortie, ce qui les rend composables avec tout le reste : un statut HTTP combiné au corps tronqué transforme un 503 en 503 avec un corps en lambeaux. C'est précisément le scénario qui permet de vérifier si un @Timeout intervient comme prévu avant qu'un fallback ne prenne le relais.
Le chaos côté client
Jusqu'ici, Goblin s'attaquait aux requêtes que reçoit votre application. Mais une application résiliente doit aussi savoir ce qui se passe quand c'est elle qui appelle quelqu'un d'autre.
Goblin sait donc aussi perturber les appels sortants faits avec le REST Client de Quarkus, grâce à un ClientRequestFilter enregistré globalement :
- Latence côté client : le service distant est bien atteint, mais après un délai aléatoire.
- Exception côté client : l'exception est levée avant l'envoi. Le service distant ne voit jamais passer la requête.
Ces assauts réutilisent la plage de latence et l'exception configurées côté serveur, mais possèdent leurs propres interrupteurs, désactivés par défaut. Ils respectent le pourcentage de ciblage, et ignorent les filtres par package ou annotation, qui ne concernent que les endpoints entrants.
Les profils : des scénarios prêts à l'emploi
Les pannes réalistes combinent rarement un seul effet. Régler chaque paramètre à la main à chaque expérience devient vite répétitif, alors Goblin propose des profils qui regroupent une combinaison courante en une seule ligne :
properties
quarkus.goblin.assault.profile=SLOW_FAILURE| Profil | Ce qu'il active | Valeurs par défaut |
|---|---|---|
SLOW_FAILURE | latence + exception | 100 à 5000 ms, RuntimeException |
INTERMITTENT | statut HTTP | 500, à combiner avec le pourcentage de ciblage |
TIMEOUT | latence | 30 secondes fixes, idéal pour un @Timeout côté client |
Un profil est un point de départ, pas une prison : chaque interrupteur reste modifiable ensuite depuis la Dev UI. Attention tout de même, au démarrage, un profil différent de NONE l'emporte sur la configuration statique.
Ciblage et précision
Provoquer du chaos ne signifie pas nécessairement tout casser. Goblin permet de contrôler précisément où, quand et à quelle fréquence le chaos intervient :
# Cibler 30% des requêtes
quarkus.goblin.target.level=30

# Inclure uniquement un package spécifique
quarkus.goblin.target.include-packages=com.example.api

# Exclure les health checks
quarkus.goblin.target.exclude-packages=com.example.health

# Ignorer les endpoints déjà protégés par Fault Tolerance
quarkus.goblin.target.exclude-annotations=org.eclipse.microprofile.faulttolerance.Timeout,org.eclipse.microprofile.faulttolerance.Fallback
On peut ainsi commencer avec un niveau de chaos très contrôlé (10 % des requêtes), observer le comportement de l'application, puis élargir progressivement l'expérience.
Configuration et activation
L'ajout de Goblin se fait en une dépendance :
<dependency>
    <groupId>io.quarkiverse.goblin</groupId>
    <artifactId>quarkus-goblin</artifactId>
    <version>0.1.0</version> <!-- dernière release en date -->
</dependency>
Au démarrage en mode dev, un WARN vous confirme que le chaos est actif, avec l'état de chaque assaut. Par défaut, c'est la latence à 100 % des requêtes. L'activation se règle dans application.properties :
quarkus.goblin.enabled=true
quarkus.goblin.assault.type=latency
quarkus.goblin.assault.latency.min-milliseconds=500
quarkus.goblin.assault.latency.max-milliseconds=2000
quarkus.goblin.target.level=100
Ou, plus simplement, depuis la Dev UI.
Le chaos dans la Dev UI
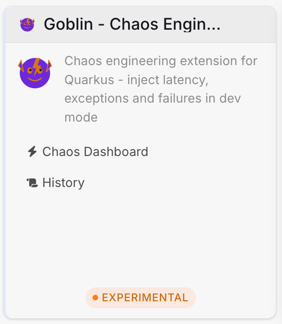
Goblin s'intègre nativement à la Dev UI de Quarkus. En accédant à /q/dev, on trouve une carte dédiée qui ouvre un Chaos Dashboard complet :
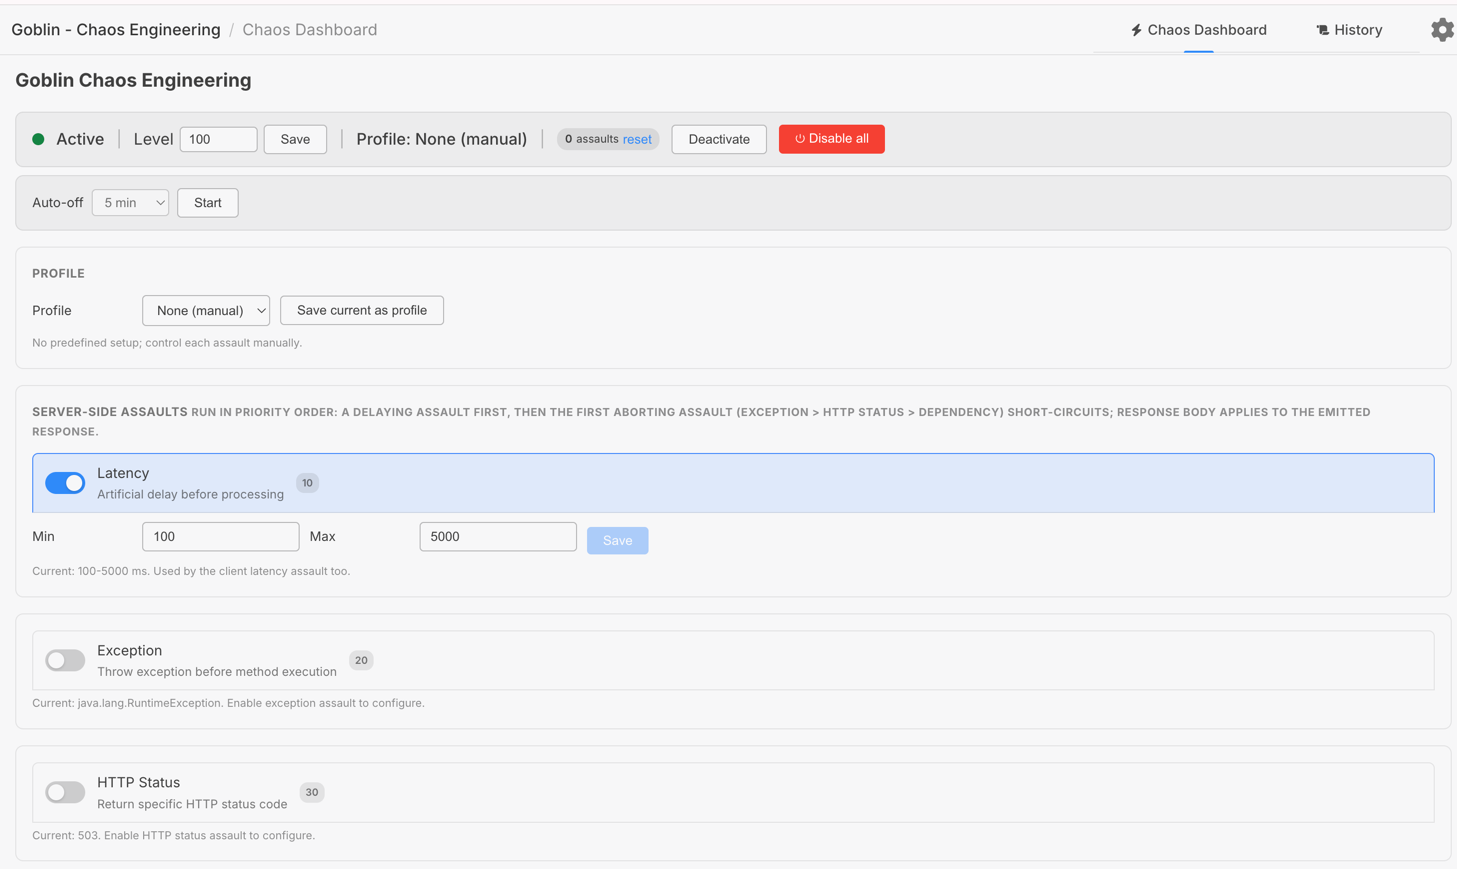
Depuis ce dashboard, on peut :
- Activer/désactiver le chaos globalement, ou tout couper d'un coup avec le kill switch (il désactive le moteur, chaque assaut, y compris côté client, et remet le profil à
NONE) - Armer un auto-off : le chaos se coupe tout seul après un compte à rebours de 15 à 600 secondes, pour ne pas oublier qu'on l'a laissé tourner
- Régler le rayon d'explosion (0 à 100 %) directement à côté de l'interrupteur principal
- Choisir un profil en un clic, ou sauvegarder ses propres profils pour les rejouer plus tard
- Basculer chaque type d'assaut indépendamment, avec son ordre de priorité affiché
- Configurer les paramètres de chaque assaut en temps réel, avec des quick picks (des présets en un clic, dont des classes d'exception vérifiées comme lançables)
- Exporter, importer ou réinitialiser toute la configuration dans la « danger zone »
- Suivre en direct le nombre d'assauts déclenchés, avec le détail par type
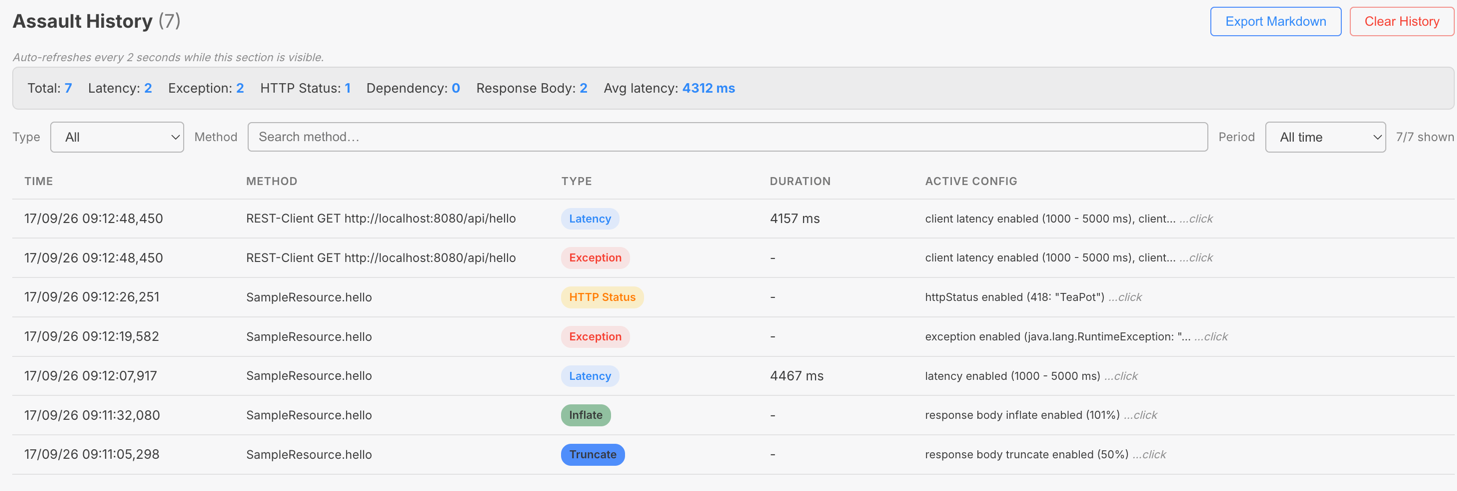
L'historique s'est lui aussi transformé. Il se rafraîchit toutes les 2 secondes, affiche un badge coloré par type d'assaut, la latence réellement appliquée, et un instantané de la configuration active au moment de chaque assaut. Une barre de filtres permet de trier par type, par méthode ou par période, et un bandeau de synthèse donne les totaux et la latence moyenne.
Il peut toujours être exporté en Markdown pour documenter une session de Chaos Engineering (ma première demande d'évolution). Le rapport est volontairement factuel : il consigne ce que Goblin a observé, sans juger la résilience de l'application. Il fait donc un excellent matériau pour un assistant IA chargé de relire et de durcir vos endpoints : les faits sont là (« GET /api/orders a subi 4945 ms de latence à 10h37 »), le verdict reste à la personne qui relit.
Un outil de développement, pas de production
Mais la décision la plus importante concernait la sécurité.
Je ne voulais pas créer une fonctionnalité qu'il faudrait absolument penser à désactiver avant chaque déploiement.
Je ne voulais pas d'un :
quarkus.goblin.enabled=false
que quelqu'un pourrait oublier un vendredi soir.
Le chaos de Goblin n'est donc pas simplement désactivé en production : il est conçu pour ne pas y exister.
L'architecture en trois modules le garantit :
quarkus-goblin(runtime) - le cœur de l'extension, toujours présent sur le classpathquarkus-goblin-dev(runtime-dev) - le service JSON-RPC pour la Dev UI, inclus uniquement en mode dev/test via une dépendance conditionnellequarkus-goblin-deployment(deployment) - les étapes de build, jamais incluses dans le JAR de production
Le build step GoblinBuildStep ne déclenche l'activation du chaos que lorsque le LaunchMode est DEVELOPMENT ou TEST. En production, l'AssaultEngine n'est jamais initialisé, et les artefacts de la Dev UI sont physiquement absents du JAR final. Il n'y a pas de toggle à oublier, le code n'est tout simplement pas là.
C'était important pour moi, parce que le Chaos Engineering doit permettre d'expérimenter avec confiance. On doit pouvoir provoquer volontairement une panne sans introduire accidentellement un mécanisme de panne dans l'application que l'on s'apprête à déployer.
Le principe pouvait finalement se résumer très simplement :
Lance ton application. Active le chaos. Observe ce qui se passe.
Et c'est ainsi que Goblin est né, avec un objectif au départ très simple : combler ce fameux trou dans la raquette.
Et maintenant ?
Goblin est aujourd'hui une extension open source disponible sur GitHub et sur Maven Central. Elle est encore en statut preview, mais fonctionnelle et testée.
 quarkiverse
Si vous utilisez Quarkus et que vous vous êtes déjà posé la question « est-ce que mon @Timeout fonctionne vraiment ? », Goblin est probablement l'outil qu'il vous faut.
Et ce @Timeout(1) du début, alors ? Est-il vraiment déclenché ? Le fallback prend-il le relais ? Ce sera l'objet d'un prochain article, où nous lâcherons le gobelin dans la taverne de The Falling Whale.
Ils en parlent :
 Markus Eisele
Markus Eisele lui a consacré un article sur The Main Thread
Depuis le 23 octobre, Goblin est officiellement stable et la version 1.0.0 est disponible 🎉🥳.