Dans un précédent article, nous présentions BMAD (Breakthrough Method for Agile AI-Driven Development) comme un moyen de sortir du prompting anarchique grâce à une équipe d'agents spécialisés : Product Manager, Architecte, Développeur, QA.
À l'usage, sur des bases de code existantes (un terrain que décrit bien ce retour d'expérience BMAD du greenfield au brownfield) et des projets de plusieurs semaines, trois limites apparaissent vite :
- l'amnésie : chaque nouvelle session repart de zéro ;
- la dérive architecturale : des unités construites séparément divergent en silence ;
- la complaisance : un agent valide trop vite un choix fragile, du moment que ça compile.
Entre la v6.9 (juin 2026) et la v6.12 (septembre 2026), BMAD a répondu à chacune. Et la réponse est contre-intuitive : le framework n'a pas ajouté des agents, il en a retiré, et il a déplacé le contrôle du prompt vers du code ordinaire. La V7, encore en preview alpha, change surtout la façon de distribuer tout cela.
À retenir si vous n'avez que deux minutesSpine d'architecture, memlog, Forge Idea, boucles autonomes : tout est déjà dans la v6.12 stable. Pas besoin d'attendre la V7.La V7 change la distribution (Skills CLI au lieu de l'installeur npm), pas la méthode.L'autonomie de BMAD est bornée : un worker ne clôt jamais lui-même un ticket, et l'orchestrateur est un programme, pas une session LLM.
1. Ce qui a changé, release par release
| Version | Date | Ce qui compte |
|---|---|---|
| v6.9 | juin 2026 | bmad-architecture et ARCHITECTURE-SPINE.md, memlog partagé, bmad-forge-idea, parties personnalisées |
| v6.10 | juillet 2026 | Module bmad-loop, worker non supervisé bmad-dev-auto, Anti-Consensus Club ; bmad-investigate retiré |
| v6.11 | août 2026 | Quick Dev devient Build (bmad-build, bmad-build-auto) ; le core passe de 14 à 8 skills ; uv obligatoire |
| v6.12 | septembre 2026 | Build choisit son niveau de cérémonie après avoir analysé le changement ; branche gelée hors correctifs |
| V7 | preview alpha | Installation par Skills CLI, modules à la carte, uv run généralisé |
Au passage, bmad-investigate, introduit en v6.7, a été retiré en v6.10 : il arrivait aux mêmes conclusions qu'une investigation classique, pour plus cher.
2. L'autonomie bornée : bmad-build-auto et bmad-loop
Jusqu'ici, le développeur restait un micro-manager : valider chaque plan, relancer l'agent après chaque story, vérifier que les contraintes n'avaient pas été oubliées en route.
BMAD sépare désormais deux responsabilités que l'on confond souvent.
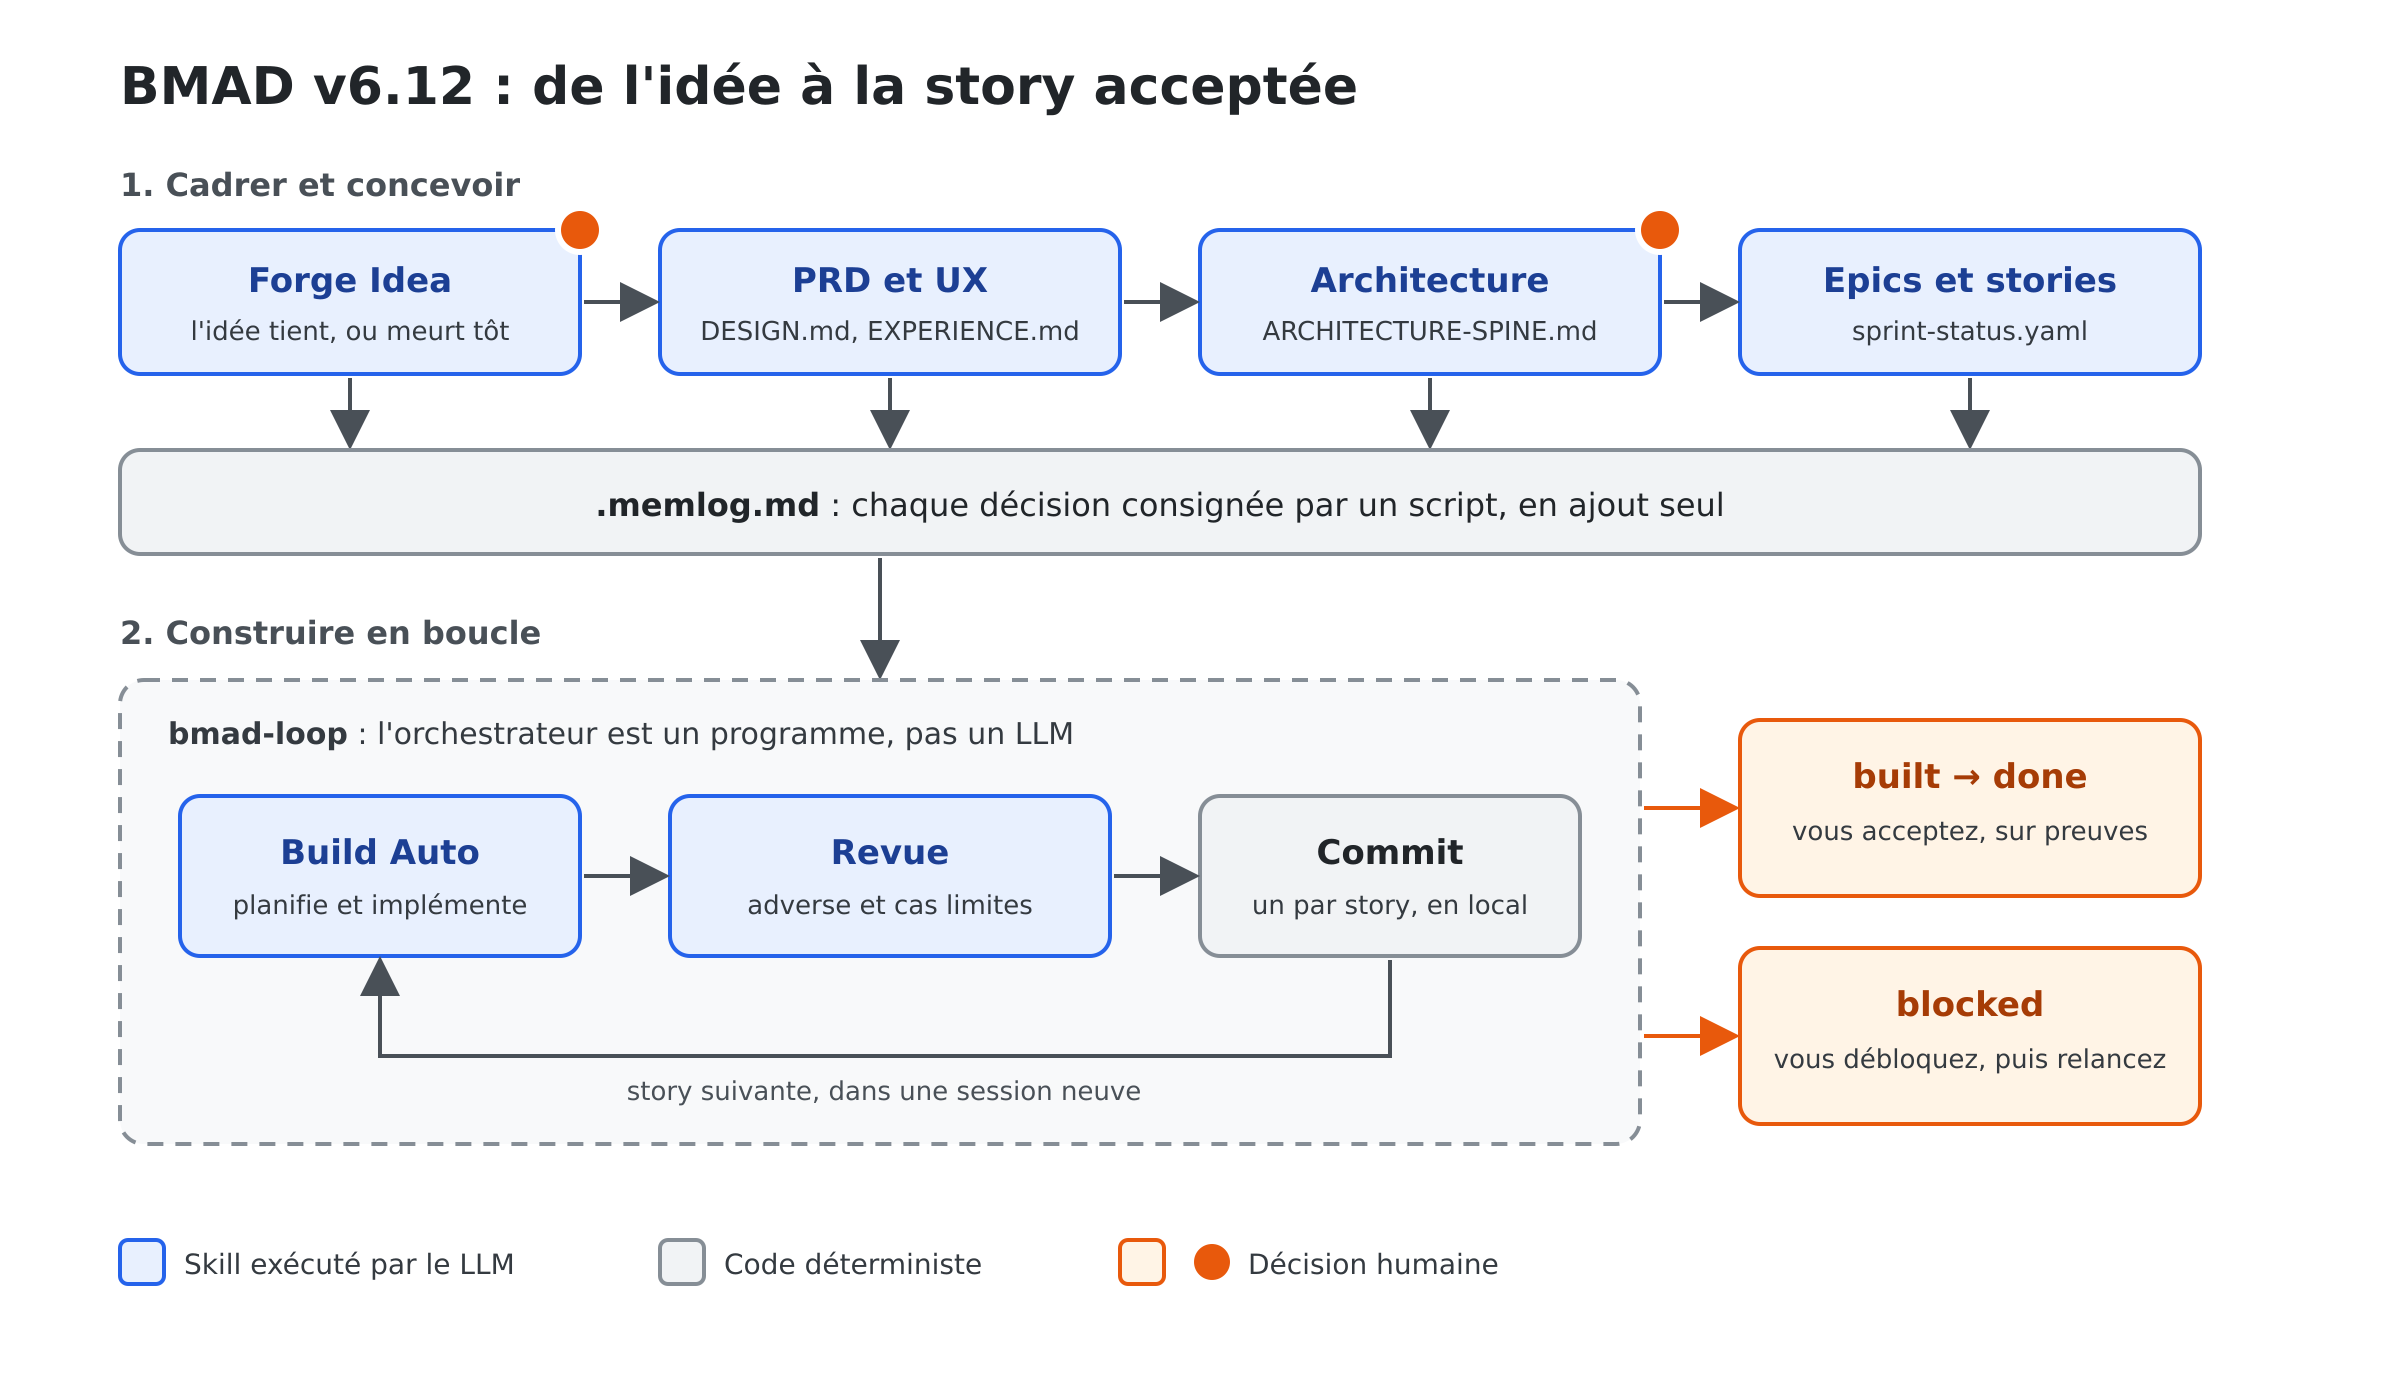
Le worker : bmad-build-auto (appelé bmad-dev-auto avant la v6.11). Une invocation traite une unité de travail : il clarifie l'intention, écrit ou reprend un plan, implémente, passe une revue, puis commit en local, sans push. Il ne choisit pas le ticket suivant et ne coordonne aucun epic.
L'orchestrateur : bmad-loop. C'est un module optionnel, et surtout un programme classique, pas une session LLM. Il lance une session neuve de votre outil de code pour chaque story, lit le résultat sur disque et décide de la suite.
sprint-status.yaml : story « ready-for-dev »
  │
  ├─ DEV      session neuve  → /bmad-build-auto <story>
  ├─ REVIEW   session neuve  → revue de suivi, si le worker la recommande
  └─ COMMIT   l'orchestrateur regroupe le travail en un commit par story
              (isolation optionnelle par git worktree)
Une machine à états lisible par une machine
Le worker ne « dit » pas qu'il a fini : il écrit un statut dans le frontmatter de son plan, que l'orchestrateur lit sans jamais interpréter le texte du chat. C'est le même principe que celui défendu dans Un agent de code ne doit jamais affirmer ce qu'il n'a pas vérifié : on se fie à un fait enregistré, pas à une déclaration.
| Statut | Signification |
|---|---|
draft, ready-for-dev | Plan en cours, puis prêt à implémenter |
in-progress, in-review | Implémentation, puis revue et triage |
built | Run terminé, en attente d'acceptation |
blocked | Poursuivre sans supervision serait risqué |
done | Posé par un humain ou par l'orchestrateur, jamais par le worker |
Les motifs de blocage sont explicites : intention ambiguë, vérification en échec, ou boucle de correction qui ne converge pas après cinq itérations. La documentation le formule bien : blocked est un signal de routage, pas seulement un échec.
C'est là que se joue la différence avec une boucle « while true » branchée sur un LLM : les décisions de pilotage sont prises par du code, reproductible et testable.
En pratique : lancer une boucle
bmad-loop demande une v6.10 ou plus, Python 3.11+, git et tmux. Il pilote six outils de code en ligne de commande, Claude Code servant de profil de référence.
bmad-loop init            # installe les skills, les hooks et policy.toml
bmad-loop validate        # vérifie config, board, git, CLI et hooks
bmad-loop run --dry-run   # affiche le plan sans lancer aucune session
bmad-loop run             # exécute l'epic
Les garde-fous se règlent dans .bmad-loop/policy.toml, et les valeurs par défaut sont prudentes :
- 3 cycles de revue au maximum par story ;
- une story qui épuise ses tentatives est mise de côté et la boucle passe à la suivante, au lieu de s'acharner ;
- une escalade critique met tout en pause et vous notifie ;
bmad-loop resolvepermet de corriger la spec puis de relancer ; - ce que seul un humain peut faire attend un
bmad-loop confirm.
Mon conseil : activez l'isolation par worktree. Chaque story tourne alors sur sa propre branche, et votre copie de travail reste libre pendant que la boucle avance.
Une revue qui ne connaît pas l'intention de l'auteur
Depuis la v6.11, les relecteurs historiques sont devenus des lenses d'un skill unique, bmad-review :
- Adversarial (l'ancien Blind Hunter) : relit le diff sans connaître l'intention ni le raisonnement de l'auteur, et cherche ce qui manque autant que ce qui est faux.
- Edge case (l'ancien Edge Case Hunter) : parcourt chaque branche et chaque condition limite, et ne remonte que les cas non gérés. C'est une méthode, pas une posture.
- Verification gap : repère les changements de comportement qui pourraient régresser sans qu'aucun test ne le voie.
Chaque constat est ensuite trié, et depuis la v6.12 le verdict de ce tri est journalisé.
Ces relecteurs répondent à un problème bien identifié du harness engineering : un agent qui valide son propre travail reste juge et partie.
Une réserve, que la documentation assume : en mode autonome, la revue par défaut est rapide. BMAD recommande qu'un humain ou un pipeline lance une revue approfondie sur chaque changement. Le worker expose d'ailleurs un champ risk pour moduler ce niveau d'exigence en CI.
3. Le Context Engineering versionné : la spine et le memlog
C'est l'évolution la plus structurante pour un projet d'entreprise, et elle est disponible depuis la v6.9. L'idée de fond, utiliser le système de fichiers comme mémoire de travail de l'agent, est la même que celle des DeepAgents de LangChain : ici, elle est appliquée à tout le cycle de développement.
 bmad-forge-idea        →  l'idée tient-elle ? (ou meurt-elle à peu de frais ?)
 bmad-prd / bmad-ux     →  PRD, DESIGN.md, EXPERIENCE.md
 bmad-architecture      →  ARCHITECTURE-SPINE.md (invariants uniquement)
 epics et stories       →  sprint-status.yaml
 bmad-build[-auto]      →  code + plan par story + revue
 bmad-retrospective     →  l'epic est-il accepté, preuves à l'appui ?
ARCHITECTURE-SPINE.md : des invariants, pas un dossier d'architecture
Le skill bmad-architecture remplace l'ancien parcours en étapes fixes. Il produit une spine volontairement courte : paradigme de conception, règles de frontières et de dépendances, propriété de l'état. Autrement dit, uniquement ce qui empêche des unités construites séparément de diverger.
Les epics et les stories en aval s'appuient sur elle. Avant finalisation, elle passe un contrôle déterministe (lint_spine.py) puis, en option, une relecture par des sous-agents.
Le même principe vaut pour l'UX depuis la v6.8, avec deux spines : DESIGN.md pour l'identité visuelle, EXPERIENCE.md pour les parcours.
.memlog.md : de l'event sourcing appliqué aux décisions
Pour traiter l'amnésie, BMAD a remplacé ses journaux de décision propres à chaque skill par un memlog commun. Trois propriétés le rendent intéressant :
- Il est append-only. Une ligne par décision, contrainte, hypothèse ou question ouverte, dans l'ordre où elles sont arrivées. Rien n'est modifié ni réordonné.
- Il est écrit par un script (
memlog.py), jamais à la main. Le LLM propose, le code enregistre. - Il vit à côté de chaque document (un memlog pour le brief, un pour la spec, un pour la spine…), et non dans un journal unique à la racine.
L'enregistrement d'une décision tient en une commande, que les skills appellent eux-mêmes :
uv run _bmad/scripts/memlog.py append --workspace <dossier-du-document> \
  --type decision --text "<la décision en une ligne, raison comprise>"
Et voici à quoi ressemble le journal d'une spec (contenu d'exemple, au format produit par le script) :
---
topic: "Authentification multi-tenant"
---
- (capability) CAP-1 Un utilisateur ne voit que les données de son organisation ; succès : aucun accès croisé en test d'intégration
- (constraint) Validation d'un token en moins de 15 ms au 95e centile
- (decision) Claims `org_id` validés à l'API Gateway plutôt que dans chaque service : une seule implémentation à auditer
- (assumption) Les clés JWKS peuvent rester en cache une heure, à confirmer avec la sécurité
- (question) Que faire d'un utilisateur rattaché à deux organisations ?
- (decision) Polling abandonné pour du SSE : le polling saturait le pool de connexions PostgreSQL ; WebSocket écarté, flux unidirectionnel
Deux détails changent tout.
Le memlog est la source canonique, et les documents en sont dérivés. SPEC.md est distillé à partir du journal et ne s'édite jamais à la main. La spine suit la même logique : pour reprendre un travail, le skill relit le memlog, qui fait autorité sur ce qui a été décidé, et non le document rendu. Les développeurs back-end reconnaîtront le principe : c'est de l'event sourcing, avec les décisions pour événements et les documents pour projections.
Les capacités portent un identifiant stable (CAP-1, CAP-2…), ce qui permet aux stories et aux revues de s'y référer sans ambiguïté d'une session à l'autre.
Le brief dit ce qu'est le produit ; le memlog garde la trace des alternatives écartées et du moment où elles l'ont été. C'est exactement le contexte qui s'évapore d'habitude à la fermeture d'une fenêtre de chat. Une étape lit des fichiers, pas l'historique de la conversation précédente : on peut fermer la session et reprendre le lendemain.
⚠️ Point de vigilance. Vérifiez ce que votre .gitignore fait de ces dossiers. Selon la configuration, les memlogs peuvent se retrouver hors du dépôt. Si vous voulez une piste d'audit partagée par l'équipe, décidez explicitement de les versionner.4. Combattre la complaisance : Forge Idea et l'Anti-Consensus Club
Quiconque travaille avec des agents connaît leur défaut : ils sont trop vite d'accord. BMAD attaque le problème à deux endroits.
bmad-forge-idea, avant toute spécification. Un interrogateur met une idée à l'épreuve, une question à la fois, avec un mode d'attaque adverse, jusqu'à ce qu'elle se durcisse ou qu'on l'abandonne. Il produit un rapport à chaque session, et un brief seulement si l'idée survit. Tuer une mauvaise idée à ce stade ne coûte presque rien.
L'Anti-Consensus Club, pour les décisions. C'est un groupe de quatre personas livré avec le Party Mode, chacun avec une fonction précise :
| Persona | Sa fonction |
|---|---|
| Wildcard | Ouvre le jeu : autres cadrages du problème, autres hypothèses, exemples |
| Level | Vérifie les affirmations : sur quoi reposent-elles, que manque-t-il, quel niveau de confiance ? |
| Splinter | Conteste l'accord trop rapide et les compromis passés sous silence |
| Killjoy | Coupe court aux redites, aux désaccords de façade et aux spéculations |
bash
/bmad-party-mode --party anti-consensus-club --mode subagentLe drapeau --mode subagent n'est pas un détail. Par défaut, un seul modèle joue tous les personas, et ils finissent par converger. En mode subagent, chaque persona est un agent distinct, qui raisonne sans voir la copie des autres. Si la différence entre les deux modèles d'exécution vous paraît floue, l'article Skills vs Agents la pose clairement.
Voici le type d'échange que l'on obtient sur un choix d'infrastructure (échange d'illustration) :
Sujet : migrer notre recherche sémantique vers pgvector.
        « Ça tient sur l'instance actuelle, zéro infra en plus. »

[Level]    Sur quoi repose « ça tient » ? 4 M de vecteurs en 1 536
           dimensions, c'est environ 24 Go pour les seuls vecteurs,
           avant le graphe HNSW. L'instance a 32 Go. Aucune mesure fournie.

[Splinter] Tout le monde a retenu « zéro infra en plus ». Personne n'a
           chiffré le coût : le cache des tables transactionnelles évincé,
           donc des écritures critiques ralenties.

[Wildcard] Autre cadrage : réduire à 512 dimensions, ou sortir la
           recherche sur un réplica dédié.

[Killjoy]  On tourne en rond sans chiffres. Il manque un benchmark,
           pas un quatrième avis.

[Vous]     Décision reportée. Benchmark en staging à 512 dimensions
           avant d'inscrire quoi que ce soit dans la spine.
Le club n'est pas un organe de vote. Il soulève les objections, vérifie les affirmations, évite les redites, puis vous rend la décision.
Une précision utile : les parties livrées avec BMAD repartent de zéro à chaque session. Pour qu'un groupe se souvienne des débats précédents, il faut l'enregistrer comme partie personnalisée en activant l'option mémoire.
5. V7 : ce qui change vraiment
La V7 ne réinvente pas la méthode. BMAD s'installe déjà sous forme de skills depuis la v6. Ce qui change, c'est le canal de distribution : on quitte l'installeur npm pour le Skills CLI, module par module.
# v6.12 stable : installeur npm
npx bmad-method install

# V7 preview alpha : Skills CLI, à la carte
npx skills add bmad-code-org/BMAD-METHOD/skills/core-tools --skill '*'
npx skills add bmad-code-org/BMAD-METHOD/skills/method --skill '*'
# puis, dans votre outil de code : demander au skill « bmad » de lancer « bmad setup »| Module | Contenu |
|---|---|
core-tools | Le skill bmad (setup, aide) et les outils transverses. Obligatoire. |
method | La méthode : planification, architecture, build, revue, rétrospective |
toolsmith | Construire, convertir, relire et empaqueter ses propres skills ; bmad-eval pour les mesurer |
founder | Un coach pour le versant business d'une startup, de l'idée à la levée de fonds |
Deux points d'attention pour une DSI :
uvn'est pas une nouveauté V7. Il est obligatoire depuis la v6.11 pour les skills compilés. La V7 généraliseuv runà tous les scripts Python.- Les scanners de sécurité vont réagir. À l'installation, le Skills CLI affiche une évaluation de risque, et certains skills BMAD sortent en risque moyen ou élevé, pour des comportements voulus (exécution de scripts, écriture de fichiers). Mieux vaut l'anticiper avec votre équipe sécurité que le découvrir en comité.
Alors, v6.12 ou V7 ?
| Critère | v6.12 (stable) | V7 (preview alpha) |
|---|---|---|
| Statut | Gelée, correctifs uniquement | Skills, installation et docs changent souvent |
| Installation | npx bmad-method install | npx skills add … puis bmad setup |
| Spine, memlog, Forge Idea, boucles | ✅ Oui | ✅ Oui |
| Pour qui | Équipes, projets en production | Solo ou petites équipes capables de pivoter |
La date de sortie de la V7, d'abord annoncée pour le 16 octobre, a glissé à mi-novembre 2026. Pour une équipe, la v6.12 reste le choix raisonnable, d'autant que la migration est outillée (bmad migrate method).
6. Trois pratiques pour passer à l'échelle
- Relisez la spine en pull request comme du code. C'est elle qui contraint tout ce que les agents produiront ensuite. Une spine approximative, c'est une dérive industrialisée.
- Ne lancez une boucle que sur des stories vérifiables. L'autonomie vaut ce que valent vos critères d'acceptation. Si aucun test ne peut dire « c'est faux », le worker dira « c'est fait ». Sur l'art de cadrer un ticket avant de le confier à un agent, voir Cadrer avant de prompter.
- Gardez un humain sur
done. Acceptez les storiesbuiltsur preuves, lancez une revue approfondie sur les changements à risque, et traitez chaqueblockedcomme une information, pas comme une panne.
Ce qu'il faut mesurer avant de généraliser
L'autonomie se pilote avec des chiffres, pas avec une impression. Sur un premier epic pilote, suivez quatre indicateurs, tous lisibles dans les artefacts que BMAD laisse sur disque :
| Indicateur | Où le lire | Ce qu'il révèle |
|---|---|---|
Part de stories blocked | Frontmatter des plans | La qualité de vos stories : une intention floue bloque dès la planification |
| Stories mises de côté | Journal de bmad-loop | Les sujets trop gros ou mal découpés pour une session |
| Cycles de revue par story | Journal de triage | Si vous touchez souvent le plafond de 3, vos critères d'acceptation sont trop lâches |
Temps humain par story built | Vos pull requests | Le vrai coût : si la relecture prend plus de temps que l'écriture, la boucle ne paie pas |
Ajoutez-y le budget de tokens par session, que bmad-loop sait surveiller, voire plafonner. Le plan qu'écrit le worker pour une story reste court, de l'ordre de 1 500 à 4 000 tokens : c'est la revue et les reprises qui font la facture. Pour aller plus loin sur ce poste de coût, le guide FinOps Claude Code reste la référence.
Conclusion : ce que BMAD nous apprend sur la suite
Ce que montrent ces dix mois, c'est une direction : réduire la part de ce qu'on demande au LLM de décider. Moins de skills (14 à 8 dans le core). Moins de cérémonie quand le changement est simple. Un orchestrateur écrit en code plutôt qu'en prompt. Une mémoire tenue par un script, dont les documents ne sont que des projections. Des relecteurs qui ignorent volontairement l'intention de l'auteur.
Le rôle du développeur se déplace en conséquence. Il écrit moins de code et pose davantage d'invariants. Il devient celui qui rédige la spine, qui définit ce qu'un test doit prouver, et qui décide, preuves en main, si built mérite de devenir done.
Les premiers assistants de code, utilisés à l'instinct, optimisaient la vitesse d'écriture. La génération d'outils qui arrive optimise autre chose : la confiance qu'on peut accorder à ce qui a été écrit sans nous.