Derrière la plupart de mes projets cartographiques, il y a une même source : data.gouv.fr, la plateforme ouverte des données publiques françaises. Pour ChronoMEL, c'est là que j'ai récupéré quatre-vingt-dix ans d'orthophotos de la métropole lilloise. Mais data.gouv.fr, ce n'est pas qu'un entrepôt de fichiers : c'est un catalogue, un cadre juridique, des indicateurs de qualité et, depuis peu, un accès en langage naturel via un serveur MCP. Tour du propriétaire à l'usage des développeurs.
Le catalogue : ce qu'on y trouve
data.gouv.fr référence plus de cinq millions de jeux de données publiés par des administrations, des collectivités, des entreprises et des citoyens. La plateforme s'organise autour de quatre objets :
- les jeux de données (datasets), chacun regroupant une ou plusieurs ressources (fichiers, API, liens) ;
- les organisations qui les publient (ministères, métropoles, opérateurs…) ;
- les réutilisations (reuses), qui montrent ce que d'autres ont construit avec une donnée, une mine d'idées et de validation ;
- les discussions, où producteurs et réutilisateurs échangent sur un jeu.
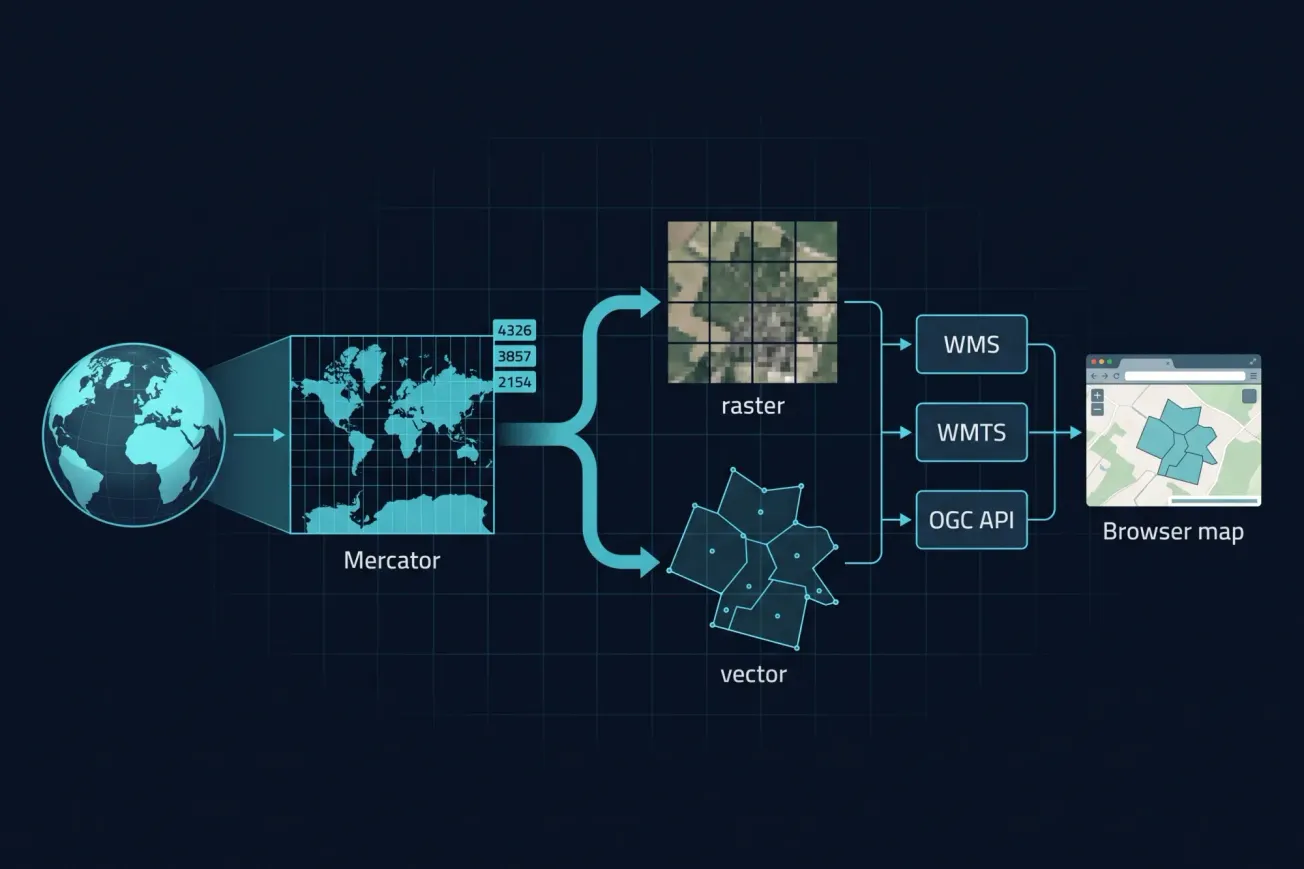
Les formats sont très variés : CSV, JSON, GeoJSON, Shapefile, GeoTIFF, mais aussi des liens vers des services (WMS, OGC API…). Je décris ces formats et standards géo en détail dans un autre article. C'est important à intégrer dès le départ : data.gouv.fr référence la donnée, mais ne la normalise pas. La qualité et le format dépendent du producteur, d'où l'importance des deux sections suivantes.
Deux mécanismes méritent d'être connus, parce qu'ils expliquent l'ampleur du catalogue.
D'abord le moissonnage : data.gouv.fr aspire automatiquement les catalogues d'autres plateformes (régions, opérateurs, portails européens), ce qui gonfle le nombre de jeux mais signifie aussi que la « vraie » source est parfois ailleurs. Pour la donnée géographique, cette source amont est souvent la Géoplateforme de l'IGN, qui diffuse ses référentiels en flux normalisés là où data.gouv.fr n'en référence que la fiche.
Ensuite les schémas de données (schema.data.gouv.fr) : des modèles standardisés que les producteurs peuvent suivre pour qu'un même type de donnée (adresses, équipements, subventions…) ait partout la même structure. Quand un jeu respecte un schéma connu, on peut écrire un parseur réutilisable au lieu d'un code sur mesure, un gain énorme à l'échelle.
Le paysage des licences : Licence Ouverte vs ODbL
La licence conditionne ce qu'on a le droit de faire de la donnée. Sur data.gouv.fr, deux dominent.
La Licence Ouverte, publiée par Etalab, est la licence française de référence pour la réutilisation des données publiques. Très permissive, elle autorise la réutilisation libre, y compris commerciale, la modification, la rediffusion, à une seule condition : mentionner la source (la paternité). Elle est pensée comme compatible avec les standards internationaux comme CC-BY et ODC-BY. C'est la licence de la majorité des jeux de données de la plateforme. Le réflexe : créditer l'auteur dans son produit, par exemple « © Métropole Européenne de Lille, Licence Ouverte » dans l'attribution d'une carte.
L'autre licence fréquente est l'ODbL (Open Database License), celle d'OpenStreetMap. Elle ressemble à la Licence Ouverte sur la liberté d'usage, mais ajoute une clause de partage à l'identique : si l'on redistribue une base dérivée, elle doit l'être sous la même licence. Cette différence compte pour un produit : elle propage l'obligation de partage à son propre jeu de données dérivé, s'il est redistribué, une logique proche du copyleft qu'on retrouve dans certaines licences open source. À ne pas confondre, donc, avec la Licence Ouverte, plus simple à intégrer dans un projet propriétaire.
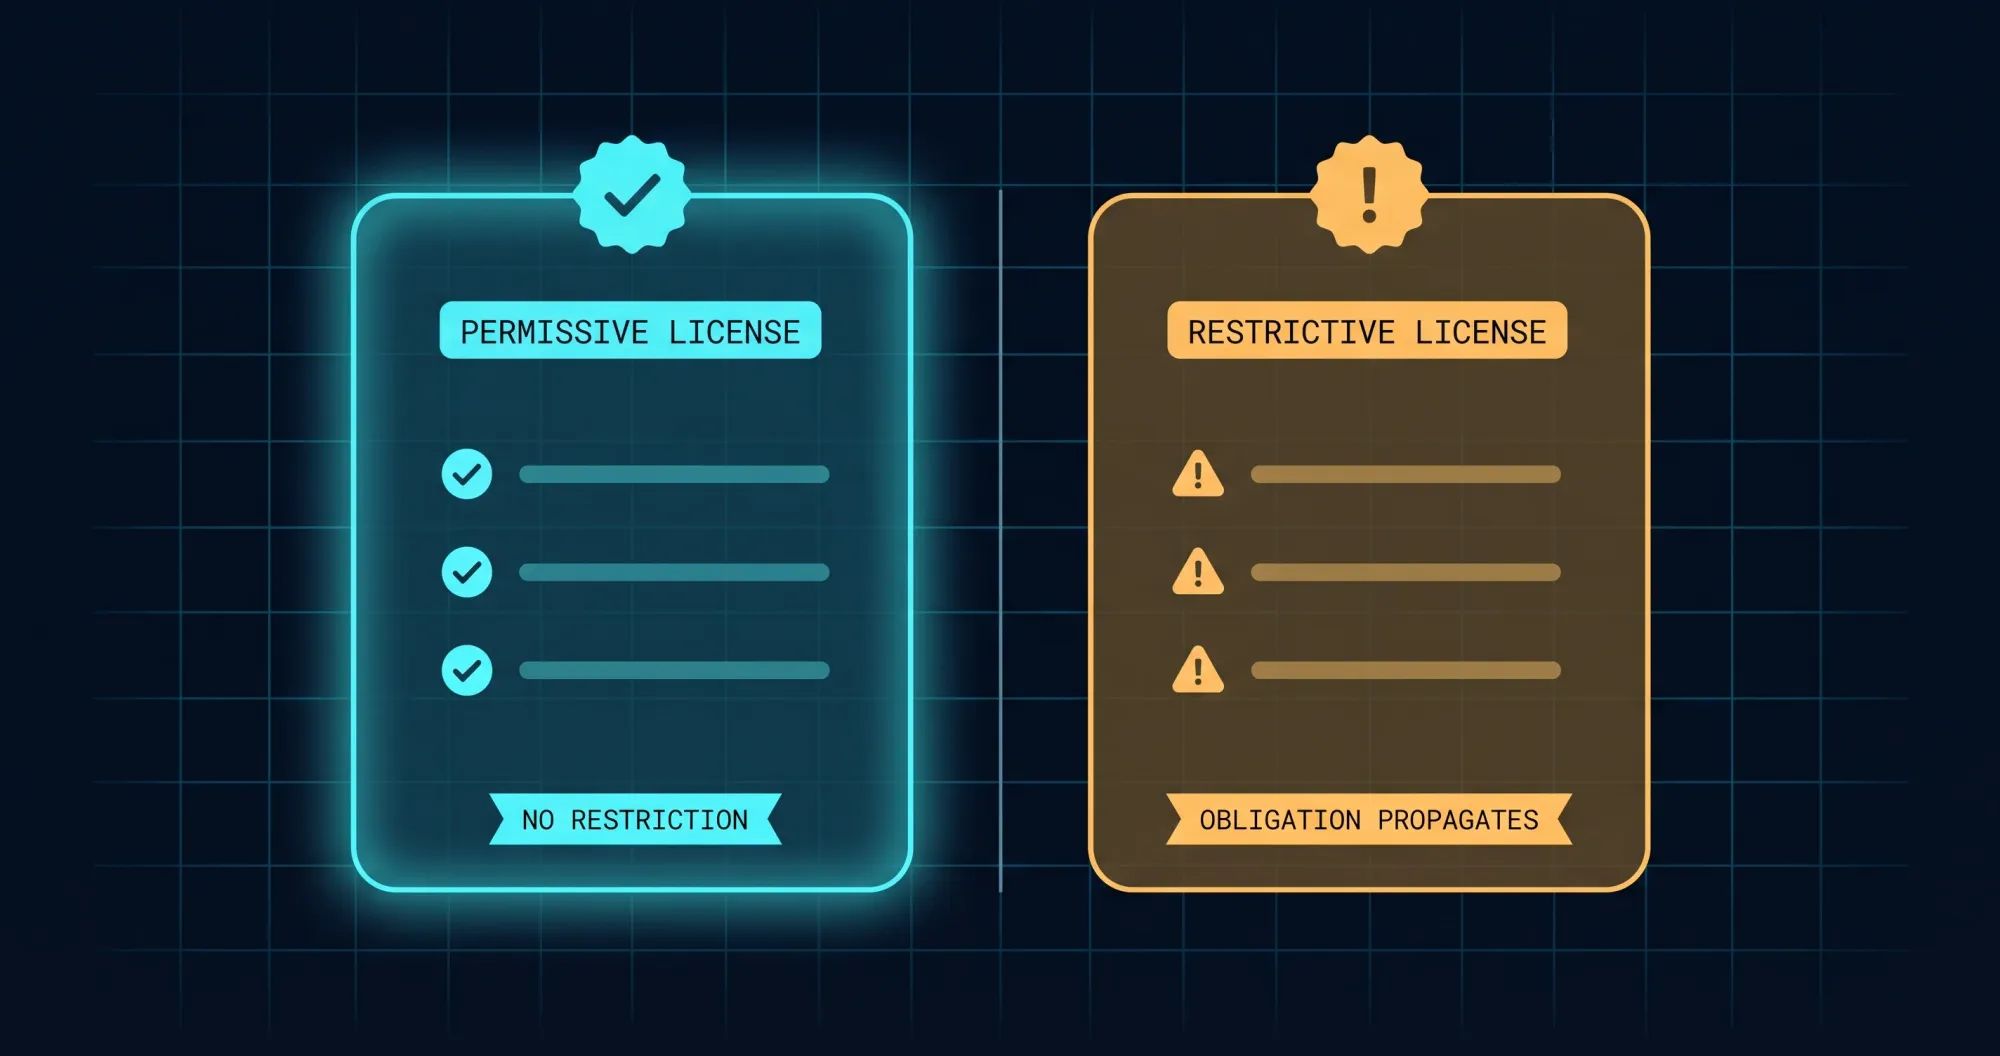
La règle d'or : vérifier la licence avant d'écrire la moindre ligne de code. La permissivité d'une donnée publique n'est pas automatique.
Juger la qualité avant d'investir
Toutes les données ne se valent pas, et brancher son code sur un jeu mal tenu, c'est s'exposer à des mises à jour qui s'arrêtent ou à des champs qui changent sans préavis. data.gouv.fr fournit pour cela un score de qualité des métadonnées, affiché sur chaque jeu. Il évalue la complétude de plusieurs éléments :
- la description des données ;
- la régularité des mises à jour ;
- la présence d'une licence explicite ;
- les métadonnées des ressources (formats, descriptions) ;
- les couvertures spatiale et temporelle.
À ce socle s'ajoute une dimension communautaire : popularité et activité (vues, téléchargements, discussions), votes positifs ou négatifs, signalements. Un jeu très consulté et discuté est généralement un jeu vivant, un bon signal de fiabilité.
Le score n'est pas une garantie absolue : il mesure la documentation, pas la justesse de chaque cellule. Mais c'est un excellent filtre de premier tri. Pour ChronoMEL, c'est ce qui m'a permis de privilégier les millésimes les mieux documentés et de repérer ceux dont la couverture était incomplète.
Consommer la donnée par l'API
data.gouv.fr expose une API REST qui permet de tout faire par programme : rechercher des jeux, lister leurs ressources, récupérer les métadonnées. C'est ce qu'on automatise dans un script de collecte, pour ne pas dépendre de copier-coller manuels d'URL :
const r = await fetch(
  'https://www.data.gouv.fr/api/1/datasets/?q=orthophotographie+MEL&page_size=20'
);
const { data } = await r.json();
data.forEach((d) => console.log(d.title, d.license));
On y récupère, pour chaque jeu, l'identifiant, la licence, la liste des ressources et leurs URLs directes : exactement ce qu'il faut pour bâtir, par exemple, la liste de tous les millésimes d'orthophotos disponibles et les câbler en couches WMS. L'API gère la pagination (page, page_size) et accepte de nombreux filtres (par organisation, par format, par tag), ce qui permet de cibler précisément un sous-ensemble sans tout télécharger.
Les pièges de l'open data
Consommer de la donnée publique, ce n'est pas consommer une API commerciale avec son SLA. Quelques pièges reviennent, et mieux vaut les anticiper :
- Les liens morts. Une ressource pointe vers un fichier déplacé ou supprimé. Un script de collecte doit gérer les
404sans planter, et idéalement archiver les URLs qui marchent. - L'abandon silencieux. Un jeu « à jour annuellement » qui n'a plus bougé depuis trois ans. Le champ de dernière modification et le score de qualité sont les garde-fous.
- L'incohérence entre millésimes. Sur ChronoMEL, d'une année à l'autre, le nom des couches, le format ou la projection pouvaient changer. La donnée historique est rarement homogène : prévoir une couche d'adaptation par millésime plutôt qu'un code unique optimiste.
- Les métadonnées trompeuses. Une licence non renseignée n'est pas une licence permissive : en l'absence de mention claire, on contacte le producteur plutôt que de présumer.
Aucun de ces pièges n'est rédhibitoire : ce sont les conditions normales de la donnée ouverte. Les ignorer, en revanche, c'est livrer un produit qui casse au premier jeu mis à jour.
Le serveur MCP : explorer le catalogue en langage naturel
Nouveauté notable : data.gouv.fr a déployé l'un des premiers serveurs MCP publics français. Le Model Context Protocol, standard ouvert introduit par Anthropic fin 2024, permet à un agent conversationnel d'appeler des outils externes de façon structurée. Concrètement, on peut désormais interroger les cinq millions de jeux en langage naturel depuis un assistant compatible.
Le serveur expose des outils orientés « catalogue » : rechercher des jeux de données, explorer leurs métadonnées, lister et interroger leurs ressources. Une instance publique est disponible sans restriction d'accès à l'adresse https://mcp.data.gouv.fr/mcp. C'est extrêmement pratique en phase d'exploration : au lieu de naviguer le site à la main, on demande à son assistant « quels jeux d'orthophotographie la MEL a-t-elle publiés, et sous quelle licence ? » et on récupère une réponse exploitable. À garder en tête : le serveur est encore expérimental, son périmètre et sa configuration peuvent évoluer. Côté implémentation, créer son propre serveur MCP dans Spring Boot suit les mêmes principes.
Conclusion
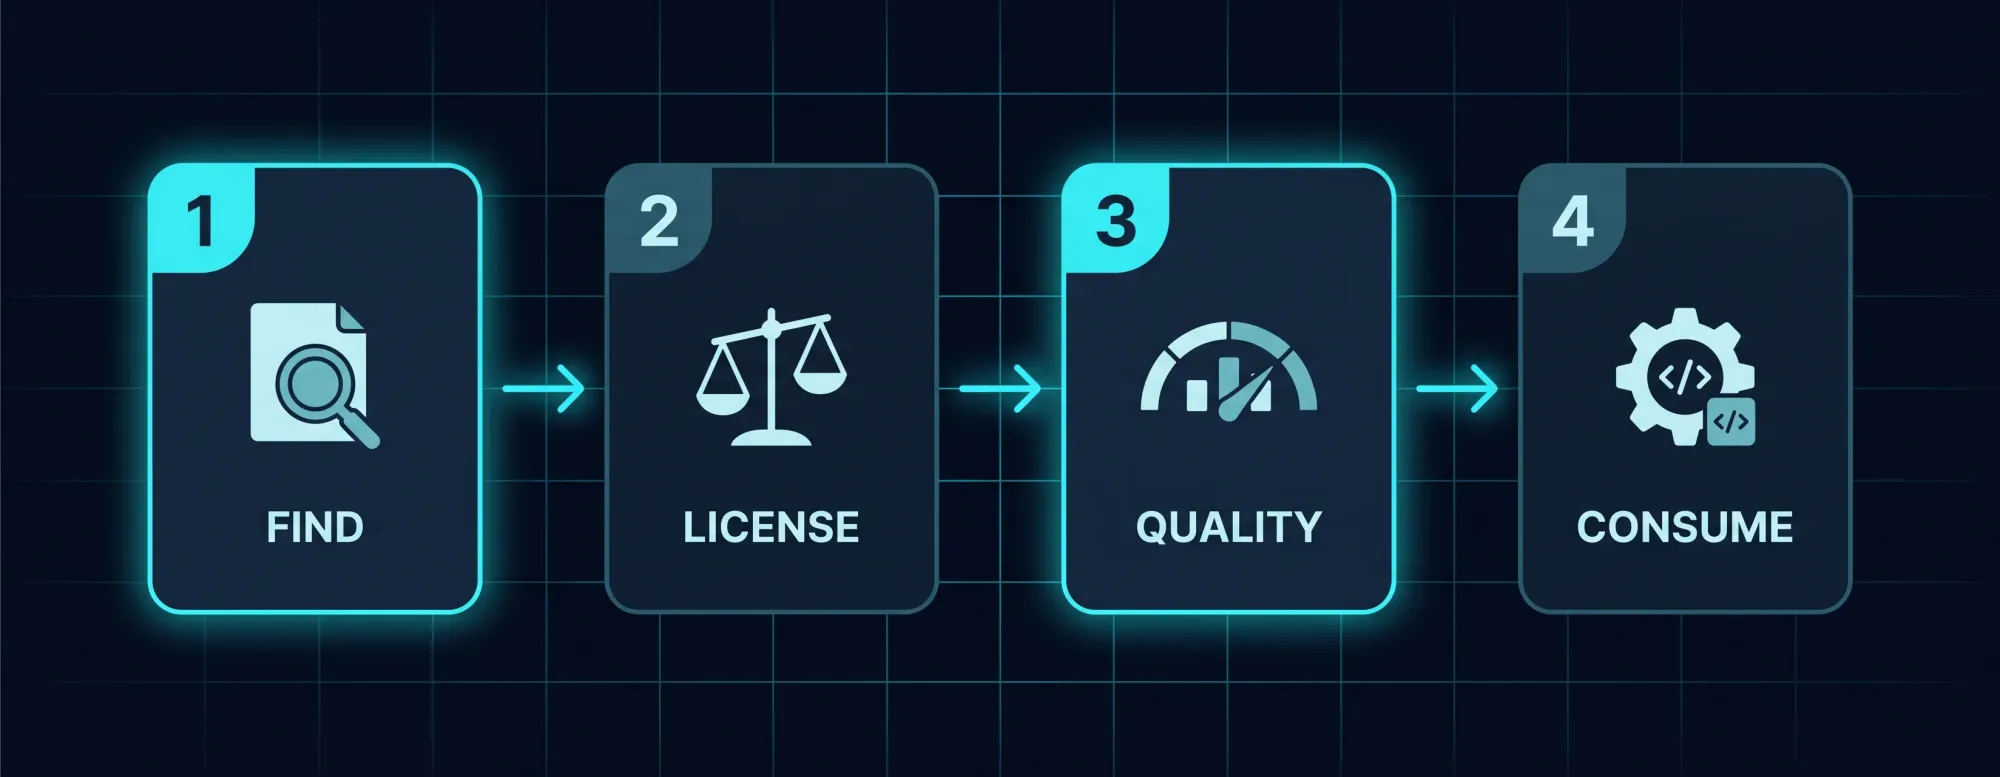
data.gouv.fr est bien plus qu'un dépôt de fichiers : c'est une chaîne complète, de la découverte à la consommation. Le bon réflexe de développeur tient en quatre temps : trouver la donnée (catalogue, API, MCP), vérifier sa licence (Licence Ouverte ou ODbL, l'écart compte), juger sa qualité (le score et les signaux communautaires), puis seulement la consommer dans son code. La matière première de l'open data territorial est là, gratuite et abondante ; ce qui fait la différence, c'est la rigueur avec laquelle on la choisit.
Reste à en faire quelque chose : quatre-vingt-dix ans d'orthophotos de la métropole lilloise, affichés dans le navigateur.