Il est 22h passées, à The Falling Whale. À la Table du Dragon, un nain repousse sa chope vide et plisse les yeux devant l'addition que Brunehilde vient de griffonner au charbon sur un bout d'écorce : "Quarante-cinq pièces d'or et trente d'argent ? J'ai bu deux chopes, pas trois !". Brunehilde soupire. Impossible de prouver quoi que ce soit : l'écorce est déjà à moitié effacée.
Le lendemain matin, rebelote, mais de l'autre côté du comptoir. Le livreur de la Brasserie Barbe-de-Fer dépose quatre tonneaux et tend un parchemin froissé, couvert de ratures, qui fait office de facture. Le tavernier cherche la TVA, ne la trouve pas, et range le tout dans un tiroir où dorment déjà une trentaine de parchemins du même genre.
Une taverne qui sert des centaines d'aventuriers par soir ne peut pas fonctionner comme ça. Il lui faut une imprimerie : de quoi remettre un vrai ticket de caisse à chaque client, et produire des factures propres, paginées, avec un récapitulatif de TVA lisible par n'importe quel intendant.
Dans le monde réel, cette imprimerie porte un nom un peu austère : l'éditique, c'est-à-dire la production automatisée de documents (tickets, factures, relevés, contrats). Et dans l'écosystème Java, l'outil historique pour ça s'appelle JasperReports. Voyons comment l'installer dans notre taverne Quarkus.
Pourquoi pas Qute ?
La question est légitime. La taverne sait déjà afficher des pages grâce à Qute, son scribe attitré. Pourquoi ne pas lui demander d'écrire aussi les tickets ?
Parce que Qute produit du texte (HTML, JSON, e-mails...), alors qu'une facture est un document mis en page : un format de papier, des marges, des sauts de page, un en-tête de colonnes qui se répète en haut de chaque page, un "Page 2 / 3" en pied de page. On pourrait générer du HTML puis le convertir en PDF, mais on se retrouve vite à se battre avec le CSS d'impression.
JasperReports raisonne directement en termes de pages et de bandes : un titre, un en-tête de colonnes, une bande de détail répétée pour chaque ligne, un pied de page, un résumé. C'est exactement le vocabulaire d'une imprimerie. Et un même rapport rempli peut être exporté en PDF, en XLSX, en HTML ou en CSV, même si chaque format a ses propres contraintes de rendu : un CSV reste une représentation tabulaire, pas un document paginé, et un modèle pensé pour un ticket thermique ne donnera pas automatiquement un tableur bien conçu.
Si Qute est le scribe qui écrit à la volée, JasperReports est le typographe qui compose ses plaques une bonne fois pour toutes.
Installer la presse
Le projet Quarkiverse propose une extension dédiée. Une dépendance suffit :
<dependency>
    <groupId>io.quarkiverse.jasperreports</groupId>
    <artifactId>quarkus-jasperreports</artifactId>
    <version>1.4.3</version>
</dependency>
Dans cette version, l'extension embarque JasperReports 7.1.0 (un mvn dependency:tree le confirme, et c'est à revérifier à chaque montée de version) ainsi que tout ce qu'il faut autour : l'export PDF, l'export Excel, les codes-barres, et surtout le module de polices jasperreports-fonts, dont on reparlera.
Mais son vrai apport est ailleurs : elle compile les rapports pendant le build. Un rapport JasperReports se décrit dans un fichier .jrxml (le modèle, en XML), qui doit être compilé en .jasper (un objet de rapport compilé et sérialisé) avant de pouvoir être rempli. Sans l'extension, on fait cette compilation au démarrage de l'application, ou pire, à chaque requête. Avec elle, tout est fait par Maven :
quarkus.jasperreports.build.source=src/main/jasperreports
quarkus.jasperreports.build.destination=jasperreports
Ces deux valeurs sont celles par défaut, mais je les laisse en clair pour qu'on voie bien le chemin : les .jrxml vivent dans src/main/jasperreports/, et les .jasper compilés atterrissent sur le classpath dans jasperreports/. Si un .jrxml contient une erreur, c'est le build qui échoue, pas le premier client qui demande son ticket. C'est la philosophie de Quarkus appliquée à l'éditique : tout ce qui peut être fait à la compilation doit l'être.
Attention à ne pas en attendre plus qu'elle n'en promet : la compilation valide la structure du modèle et la syntaxe de ses expressions Java, pas les données. Un champ qui renvoie null, un libellé trop long pour sa zone ou un montant mal arrondi ne se verront qu'au remplissage. Même chose pour le mode natif : l'extension vise la compatibilité GraalVM/Mandrel, mais les expressions, les ressources, les polices et les exporteurs restent à tester dans l'image réellement déployée. Les exemples de cet article ont été validés en JVM uniquement.
Le registre : des getters, pas des records
Avant d'imprimer quoi que ce soit, il faut des données. JasperReports se nourrit d'une source de données (JRDataSource), et la plus simple de toutes est JRBeanCollectionDataSource : on lui donne une liste d'objets Java, et chaque champ du rapport est lu sur l'objet courant.
Petit piège : cette source lit les champs selon les conventions JavaBean. Un champ libelle dans le rapport appelle getLibelle() sur l'objet. Les accesseurs des records Java (libelle()) ne sont pas reconnus. Les classes du modèle sont donc de bons vieux POJO à getters :
public class LigneCommande {

    private final String libelle;
    private final Integer quantite;
    private final BigDecimal prixUnitaire;

    // constructeur et getters...

    public BigDecimal getMontant() {
        return prixUnitaire.multiply(BigDecimal.valueOf(quantite));
    }
}
Le corollaire est plutôt agréable : tout getter devient un champ utilisable dans le rapport, y compris les getters calculés. getMontant() sur une ligne, getTotalTtc() ou getRecapTva() sur une facture : le calcul reste en Java, testable unitairement, et le rapport se contente d'afficher.
Deux règles pour que ça reste sain. D'abord, ces getters doivent rester simples, déterministes et peu coûteux : JasperReports peut les appeler plusieurs fois pendant le remplissage, ce n'est pas l'endroit pour une requête en base. Ensuite, toute la logique financière (arrondis, taux, cas limites) se décide en Java, avec des BigDecimal et un RoundingMode explicite. Le rapport restitue des montants, il ne les décide jamais.
La presse : ImprimerieService
Côté Java, toute l'imprimerie tient dans un seul service. Il charge les rapports compilés, les remplit avec des paramètres et une source de données, puis exporte le résultat.
private JasperReport charger(String nom) {
    return rapports.computeIfAbsent(nom, n -> {
        String emplacement = "jasperreports/" + n + ".jasper";
        try (InputStream flux = Thread.currentThread().getContextClassLoader()
                .getResourceAsStream(emplacement)) {
            if (flux == null) {
                throw new IllegalStateException("Rapport compilé introuvable : " + emplacement);
            }
            return (JasperReport) JRLoader.loadObject(flux);
        } catch (JRException | IOException e) {
            throw new IllegalStateException("Impossible de charger : " + emplacement, e);
        }
    });
}
Le test flux == null n'est pas décoratif : getResourceAsStream() renvoie null quand la ressource n'existe pas, et sans ce contrôle on récolterait une NullPointerException anonyme au fond de JRLoader, au lieu d'un message qui nomme le rapport manquant.
Chaque plaque est chargée une seule fois puis gardée en mémoire. Un rapport compilé est un objet de conception réutilisable, que l'on peut conserver en cache plutôt que de le recharger à chaque requête : c'est exactement le rôle de notre ConcurrentHashMap. Les documents produits, eux, ne sont jamais mis en cache : chaque PDF est généré à la demande (on en parlait déjà au moment de décider quoi mettre sur l'ardoise). Attention toutefois, le service renvoie un byte[] : le temps de la requête, le document complet est bien matérialisé en mémoire. C'est parfait pour des tickets et des factures de quelques dizaines de kilo-octets. Pour des documents volumineux, on exporterait plutôt vers un flux, un fichier temporaire ou un stockage objet, en maîtrisant alors la durée de vie et le nettoyage de ces ressources.
Le remplissage et l'export tiennent en quelques lignes :
public byte[] imprimerTicket(Commande commande) {
    Map<String, Object> parametres = parametresTaverne();
    parametres.put("NUMERO", commande.getNumero());
    parametres.put("TABLE", commande.getTable());
    parametres.put("SERVEUR", commande.getServeur());
    parametres.put("DATE_COMMANDE", commande.getDate());
    parametres.put("PAIEMENTS", commande.getPaiements());
    JasperPrint print = remplir("ticket-de-caisse", parametres,
            new JRBeanCollectionDataSource(commande.getLignes()));
    return exporterPdf(print);
}

private Map<String, Object> parametresTaverne() {
    Map<String, Object> parametres = new HashMap<>();
    parametres.put(JRParameter.REPORT_LOCALE, Locale.FRANCE);
    parametres.put("NOM_TAVERNE", NOM_TAVERNE);
    parametres.put("ADRESSE_TAVERNE", ADRESSE_TAVERNE);
    return parametres;
}
Deux notions à bien distinguer :
- Les paramètres (
$P{...}dans le rapport) sont des valeurs uniques pour tout le document : le nom de la taverne, le numéro de commande, la table. - Les champs (
$F{...}) viennent de la source de données et changent à chaque ligne : ici, chaqueLigneCommandedu ticket.
Le paramètre REPORT_LOCALE mérite une mention : c'est lui qui fait sortir 45,30 plutôt que 45.30, et des dates à la française.
Le ticket de caisse : un rouleau de 80 mm
Premier document : le ticket que Brunehilde aurait dû tendre au nain. Une imprimante thermique imprime sur un rouleau de 80 mm de large, soit environ 226 points, et la longueur du ticket dépend du nombre de consommations. Dans le .jrxml :
<jasperReport name="ticket-de-caisse" language="java"
              pageWidth="226" pageHeight="842" columnWidth="210"
              leftMargin="8" rightMargin="8" topMargin="8" bottomMargin="8"
              ignorePagination="true">
ignorePagination="true" est la clé. Le pageHeight n'est alors plus qu'une valeur de conception : au remplissage, JasperReports ne coupe jamais en pages et produit une seule page dont la hauteur est celle du contenu. Pas besoin de me croire sur parole, il suffit de mesurer la MediaBox des PDF générés : le ticket de la Table du Dragon (3 consommations, 2 règlements) fait 226 × 284 points, celui du Coin du Barde (1 pinte, 1 règlement) 226 × 244. Aucun des deux ne fait les 842 points déclarés. Un test le vérifie, d'ailleurs.
Le PDF s'adapte donc tout seul. L'imprimante, c'est une autre histoire : selon le pilote, une imprimante thermique peut attendre un format de page fixe, couper le papier à une longueur prédéfinie ou imprimer en flux continu. Avant de brancher l'imprimerie sur un vrai comptoir, il faut vérifier comment le couple pilote-imprimante gère ces pages de hauteur variable.
Le corps du ticket est une bande detail, répétée pour chaque ligne de la commande :
<detail>
    <band height="14" splitType="Stretch">
        <element kind="textField" x="0" y="1" width="28" height="12" hTextAlign="Right">
            <expression><![CDATA[$F{quantite} + " x"]]></expression>
        </element>
        <element kind="textField" x="34" y="1" width="106" height="12" textAdjust="StretchHeight">
            <expression><![CDATA[$F{libelle}]]></expression>
        </element>
        <element kind="textField" x="140" y="1" width="70" height="12"
                 pattern="#,##0.00 po" hTextAlign="Right">
            <expression><![CDATA[$F{montant}]]></expression>
        </element>
    </band>
</detail>
Le motif #,##0.00 po affiche les montants en pièces d'or. Et le total ? Pas besoin de le passer depuis Java : une variable de rapport s'en charge.
<variable name="TOTAL" calculation="Sum" class="java.math.BigDecimal">
    <expression><![CDATA[$F{montant}]]></expression>
</variable>
Attention, nouveau format de plaques
Si vous avez déjà croisé du JRXML, ce <element kind="textField"> vous a peut-être surpris. JasperReports 7 a changé le format XML des .jrxml : là où la v6 écrivait <textField><reportElement .../><textFieldExpression>..., la v7 écrit <element kind="textField"><expression>.... Les concepts, eux, n'ont pas bougé : paramètres, champs, variables et bandes fonctionnent comme avant. C'est la syntaxe des fichiers qui change, et un modèle v6 doit être migré avant d'être compilé par la v7, par exemple en l'ouvrant puis en le réenregistrant dans Jaspersoft Studio 7. C'est le premier piège quand on suit un tutoriel trouvé en ligne, la grande majorité date de l'ancien format.
Le composant list : le détail du règlement
Revenons au nain de la Table du Dragon. Il a payé 40 pièces d'or... et une dent de wyverne, estimée à 5,30 pièces par Brunehilde. Le ticket doit détailler ces deux règlements.
Problème : la source de données du ticket, ce sont déjà les consommations. Pour afficher une seconde collection dans le même rapport, JasperReports propose deux outils : le sous-rapport, qu'on verra juste après, et le composant list, plus léger.
Le composant list s'appuie sur un dataset secondaire, déclaré en tête du rapport :
<dataset name="Paiements">
    <field name="mode" class="java.lang.String"/>
    <field name="montant" class="java.math.BigDecimal"/>
</dataset>
<parameter name="PAIEMENTS" class="java.util.List"/>
Puis, dans le summary du ticket, on place le composant et on lui indique où trouver ses données :
<element kind="component" x="0" y="46" width="210" height="12">
    <component kind="list" printOrder="Vertical">
        <datasetRun subDataset="Paiements">
            <dataSourceExpression><![CDATA[
                new net.sf.jasperreports.engine.data.JRBeanCollectionDataSource($P{PAIEMENTS})
            ]]></dataSourceExpression>
        </datasetRun>
        <contents height="12">
            <element kind="textField" x="8" y="0" width="132" height="12">
                <expression><![CDATA["• " + $F{mode}]]></expression>
            </element>
            <element kind="textField" x="140" y="0" width="70" height="12"
                     pattern="#,##0.00 po" hTextAlign="Right">
                <expression><![CDATA[$F{montant}]]></expression>
            </element>
        </contents>
    </component>
</element>
Le bloc contents est répété pour chaque paiement. Pas de fichier supplémentaire, pas de compilation séparée : tout vit dans le ticket. Le résultat, c'est enfin un ticket que personne ne peut contester :
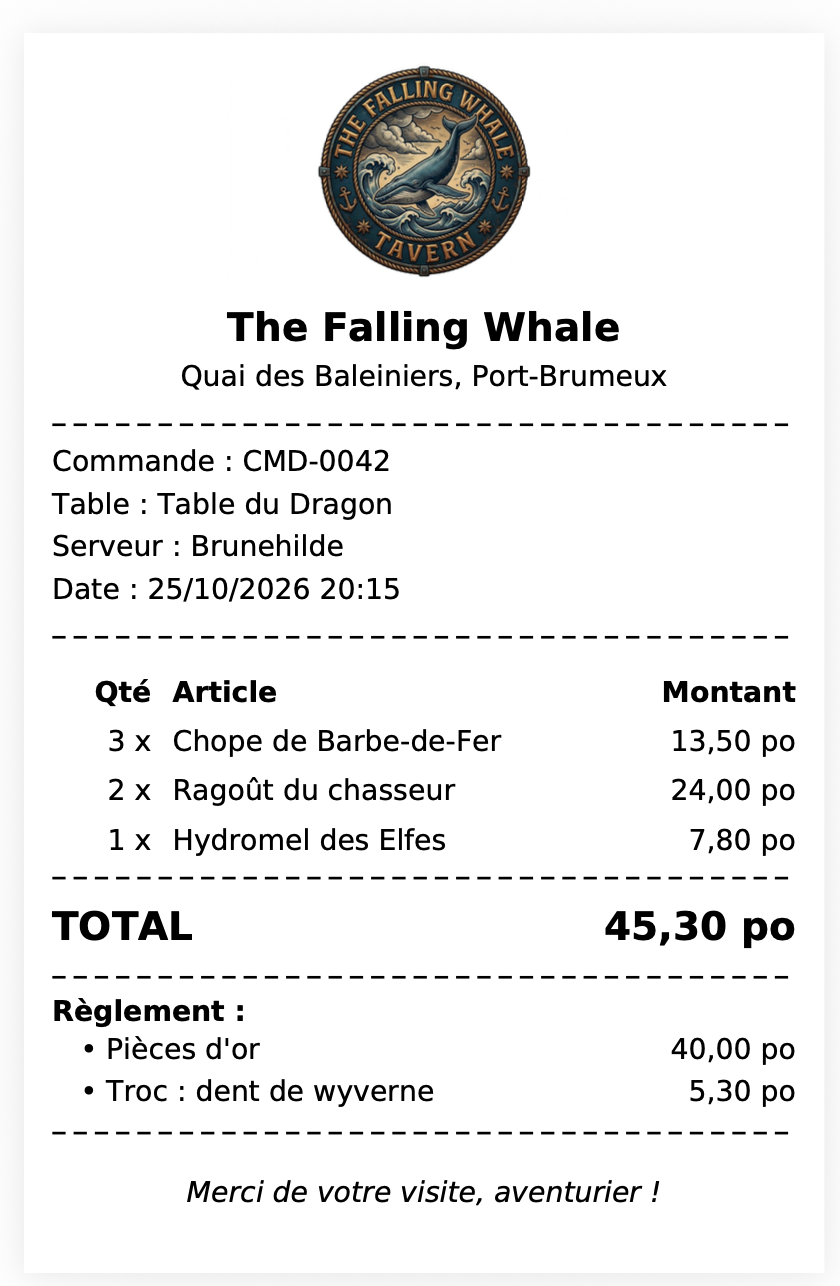
Trois chopes, noir sur blanc. Le nain peut toujours râler, mais il râlera devant une preuve.
La facture fournisseur : l'art du sous-rapport
Deuxième document, plus ambitieux : la facture A4 de la Brasserie Barbe-de-Fer. On y trouve un en-tête (fournisseur, client, dates), un tableau de lignes potentiellement long, un récapitulatif de TVA par taux, et les totaux.
C'est le terrain de jeu idéal pour le sous-rapport : un rapport à part entière (son propre .jrxml, sa propre mise en page, son propre en-tête de colonnes) inséré dans un rapport maître. La facture en utilise deux, et elle les branche chacun d'une manière différente, pour montrer les deux approches.
Le rapport maître reçoit une source de données d'un seul élément, la facture elle-même, et déclare ses collections comme des champs de type java.util.List :
<field name="lignes" class="java.util.List"/>
<field name="recapTva" class="java.util.List"/>
Premier cas : le sous-rapport passé en paramètre
Pour les lignes, c'est le Java qui charge le sous-rapport compilé et le confie au maître :
parametres.put("SOUS_RAPPORT_LIGNES", charger("facture-lignes"));
Le maître le déclare comme un paramètre de type JasperReport et l'utilise dans un élément subreport :
<element kind="subreport" x="0" y="2" width="555" height="20">
    <expression><![CDATA[$P{SOUS_RAPPORT_LIGNES}]]></expression>
    <dataSourceExpression><![CDATA[
        new net.sf.jasperreports.engine.data.JRBeanCollectionDataSource($F{lignes})
    ]]></dataSourceExpression>
    <returnValue toVariable="NB_LIGNES" subreportVariable="REPORT_COUNT"/>
</element>
L'avantage : le chargement passe par notre cache, et le Java garde la main sur le sous-rapport à utiliser (on pourrait imaginer un gabarit de lignes différent selon le fournisseur).
Deuxième cas : le sous-rapport trouvé par son chemin
Pour le récapitulatif de TVA, on laisse JasperReports se débrouiller seul :
<element kind="subreport" x="0" y="28" width="270" height="20">
    <expression><![CDATA["jasperreports/facture-recap-tva.jasper"]]></expression>
    <dataSourceExpression><![CDATA[
        new net.sf.jasperreports.engine.data.JRBeanCollectionDataSource($F{recapTva})
    ]]></dataSourceExpression>
    <parameter name="NUMERO_FACTURE">
        <expression><![CDATA[$F{numero}]]></expression>
    </parameter>
</element>
Quand l'expression est une chaîne, JasperReports la résout comme une ressource : il la cherche sur le classpath, là où l'extension a justement déposé les .jasper. Côté Java, rien à faire. C'est plus simple, mais le rapport devient dépendant de l'emplacement des fichiers compilés et du packaging : si la ressource n'est pas là où on l'attend, l'erreur surgit au remplissage, au fond de JasperReports. L'approche par paramètre, qui passe par charger(), rend le chargement explicite et centralise les erreurs. C'est celle que je privilégierais en production, la seconde étant surtout pratique pour les rapports conçus et testés depuis Jaspersoft Studio.
Faire passer des messages entre maître et sous-rapport
Les deux extraits ci-dessus cachent deux mécanismes très pratiques.
Dans le sens descendant, l'élément <parameter> transmet une valeur du maître au sous-rapport. Le récapitulatif de TVA reçoit ainsi le numéro de la facture et l'affiche sous son tableau : "Détail de la TVA de la facture FAC-BDF-2026-117". Le sous-rapport doit, bien sûr, déclarer ce paramètre de son côté (<parameter name="NUMERO_FACTURE" class="java.lang.String"/>). Attention, un sous-rapport ne voit pas les paramètres de son maître : tout ce dont il a besoin doit lui être transmis explicitement.
Dans le sens montant, <returnValue> permet au sous-rapport de renvoyer une de ses variables au maître. Ici, on récupère la variable intégrée REPORT_COUNT (le nombre de lignes traitées) dans une variable du maître :
<variable name="NB_LIGNES" calculation="System" class="java.lang.Integer"/>
La facture peut alors afficher "Lignes facturées : 3" en bas de page, sans que le Java ait compté quoi que ce soit. C'est le même mécanisme qu'on utiliserait pour remonter un sous-total calculé dans le sous-rapport.
Et pour une facture sans aucune ligne ? Le cas mérite un test, parce qu'un sous-rapport sans données n'est, par défaut, pas imprimé du tout... et ne renvoie alors rien. Ici, le sous-rapport des lignes déclare whenNoDataType="AllSectionsNoDetail" : il est rempli même vide, son REPORT_COUNT vaut 0, et la facture affiche bien "Lignes facturées : 0" plutôt qu'un null disgracieux. Un test construit une facture vide pour verrouiller ce comportement : si quelqu'un retire l'attribut un jour, il cassera.
Une démonstration, pas un logiciel de facturation
Une précision avant d'aller plus loin. Cette facture est un exemple pédagogique, pas un document conforme aux obligations comptables et fiscales. Dans un vrai système, les taux, les bases, les montants de TVA, les règles d'arrondi et les mentions obligatoires viennent de données métier validées, et dépendent du régime de chaque entreprise. Le rapport, lui, se contente de les restituer fidèlement. C'est d'ailleurs pour ça que tout le calcul vit dans FactureFournisseur et non dans le .jrxml.
La pagination, offerte
La facture de la Meunerie du Val-Doré compte 40 lignes de farines et de grains. Elle déborde naturellement sur une deuxième page, et c'est là que le sous-rapport montre tout son intérêt : son columnHeader (Réf., Désignation, Qté...) est répété automatiquement en haut de la page 2.
Pour le "Page X / Y" du pied de page, il faut une petite astuce : au moment où la page 1 est imprimée, JasperReports ne sait pas encore combien il y aura de pages. On découpe donc en deux champs :
<element kind="textField" x="400" y="6" width="125" height="14" hTextAlign="Right">
    <expression><![CDATA["Page " + $V{PAGE_NUMBER}]]></expression>
</element>
<element kind="textField" x="525" y="6" width="30" height="14" evaluationTime="Report">
    <expression><![CDATA[" / " + $V{PAGE_NUMBER}]]></expression>
</element>
Le second champ est évalué en fin de rapport (evaluationTime="Report"), quand PAGE_NUMBER contient le nombre total de pages. Il est ensuite reporté sur toutes les pages déjà produites.
Ce genre d'astuce se vérifie sur le PDF exporté, pas à l'œil sur le .jrxml. Les tests extraient le texte page par page et contrôlent "Page 1 / 1" sur la facture du brasseur, puis "Page 1 / 2" sur la première page de la meunerie et "Page 2 / 2" sur la seconde. Ils vérifient au passage que l'en-tête "Désignation" figure bien sur les deux pages : c'est le columnHeader du sous-rapport des lignes qui se répète, pas celui du maître.
Le relevé des fournisseurs : une liste dans chaque bande
Dernier document, pour l'intendant : le relevé mensuel. Pour chaque fournisseur, la liste de ses factures du mois, un sous-total, et un total général en bas.
La source de données principale est une liste de ReleveFournisseur (un fournisseur et ses factures). Chaque fournisseur occupe une bande de détail, et à l'intérieur, un composant list parcourt les factures du fournisseur courant :
<datasetRun subDataset="Factures">
    <dataSourceExpression><![CDATA[
        new net.sf.jasperreports.engine.data.JRBeanCollectionDataSource($F{factures})
    ]]></dataSourceExpression>
</datasetRun>
C'est la même mécanique que pour les paiements du ticket, à une différence près : la collection vient d'un champ ($F{factures}) et non d'un paramètre. Elle change donc à chaque bande. La Brasserie Barbe-de-Fer affiche sa facture, la Fromagerie des Collines ses deux factures, et une variable Sum sur totalTtc cumule le total général de 11 704,03 pièces d'or. Au moins, l'intendant sait à quoi s'attendre.
Sous-rapport ou composant list ?
Après ces trois documents, la question revient forcément : quand choisir l'un ou l'autre ?
| Besoin | Composant list | Sous-rapport |
|---|---|---|
| Répéter quelques champs dans un rapport | ✅ idéal | possible, mais lourd |
| Fichier séparé, réutilisable dans plusieurs rapports | ❌ | ✅ |
| En-tête de colonnes répété à chaque saut de page | ❌ | ✅ |
Bandes propres (title, summary, groupes...) |
❌ | ✅ |
| Renvoyer une valeur au rapport maître | ❌ | ✅ returnValue |
La règle que j'applique : le composant list tant que c'est une simple énumération, le sous-rapport dès que le bloc a sa propre mise en page ou doit vivre sur plusieurs pages. Les paiements d'un ticket sont une énumération ; les lignes d'une facture de 40 articles, non.
Les polices : le piège classique
Un détail qui n'en est pas un. Tous les rapports de la taverne déclarent un style par défaut :
<style name="Base" default="true" fontName="DejaVu Sans" fontSize="9.0"/>
Sans police explicitement embarquée, JasperReports utilise les polices de la machine qui génère le PDF. Sur le poste du développeur, tout va bien. Sur un conteneur Linux minimaliste en production, on obtient au mieux des accents remplacés par des carrés, au pire une exception du type "Font 'SansSerif' is not available to the JVM".
La solution est de fournir les polices via une font extension JasperReports. Bonne nouvelle : quarkus-jasperreports embarque jasperreports-fonts, qui contient la famille DejaVu. Il suffit de l'utiliser partout dans les rapports : la police est alors incorporée au PDF, ce qui stabilise fortement le rendu d'une machine à l'autre. Fortement, pas parfaitement : le lecteur PDF, l'imprimante ou un autre format d'export (XLSX, HTML) peuvent encore introduire des écarts.
Côté natif, la documentation de l'extension signale que certaines images minimales (UBI minimal, par exemple) doivent embarquer des bibliothèques système comme freetype et fontconfig pour que le rendu des polices fonctionne. Encore une raison de tester dans l'image de production, pas seulement sur son poste.
Le comptoir : servir les documents en REST
Il reste à mettre tout ça à disposition via une API REST. Rien de bien sorcier, si ce n'est le choix de l'en-tête Content-Disposition :
@GET
@Path("/commandes/{numero}/ticket")
@Produces("application/pdf")
public Response ticket(@PathParam("numero") String numero) {
    return archives.trouverCommande(numero)
            .map(commande -> Response.ok(imprimerie.imprimerTicket(commande))
                    .type("application/pdf")
                    .header("Content-Disposition",
                            "inline; filename=\"" + nomDeFichier("ticket", commande.getNumero(), "pdf") + "\"")
                    .build())
            .orElseGet(() -> Response.status(Response.Status.NOT_FOUND).build());
}

static String nomDeFichier(String prefixe, String numero, String extension) {
    String numeroAssaini = numero == null ? "" : numero.replaceAll("[^A-Za-z0-9-]", "_");
    return prefixe + "-" + numeroAssaini + "." + extension;
}
On ne recopie jamais tel quel le paramètre de chemin dans un en-tête HTTP. Ici, il ne pourrait de toute façon y arriver que s'il correspond à une commande existante, mais deux précautions valent mieux qu'une : le nom de fichier est construit à partir du numéro archivé, puis assaini. Un guillemet, un retour à la ligne ou une barre oblique deviennent de simples _ et ne peuvent plus casser l'en-tête.
inlinedemande au navigateur d'afficher le document : parfait pour un ticket qu'on consulte.attachmentdéclenche un téléchargement : c'est le choix retenu pour les factures, qu'on archive.
Et puisqu'un rapport rempli (JasperPrint) est indépendant du format de sortie, la facture s'exporte aussi en tableur pour l'intendant, via ?format=xlsx. Seul l'exporteur change :
JRXlsxExporter exporteur = new JRXlsxExporter();
exporteur.setExporterInput(new SimpleExporterInput(print));
exporteur.setExporterOutput(new SimpleOutputStreamExporterOutput(sortie));
exporteur.exportReport();
Petite subtilité, vérifiée dans les jars de la 7.1.0 : JRXlsxExporter (format .xlsx) se trouve dans le cœur de JasperReports (net.sf.jasperreports.engine.export.ooxml), alors que le module jasperreports-excel-poi ne fournit que JRXlsExporter, pour l'ancien format .xls.
Les routes de l'imprimerie :
| Route | Document | Disposition |
|---|---|---|
GET /taverne/commandes/{numero}/ticket |
Ticket de caisse (PDF) | inline |
GET /taverne/factures/{numero} |
Facture fournisseur (PDF) | attachment |
GET /taverne/factures/{numero}?format=xlsx |
Facture fournisseur (XLSX) | attachment |
GET /taverne/fournisseurs/releve |
Relevé mensuel (PDF) | inline |
Vérifier les épreuves : tester un PDF
Un imprimeur relit ses épreuves avant de lancer le tirage. Pour nos documents, c'est PDFBox qui joue le relecteur : il relit le PDF produit et en extrait le texte, sur lequel on peut écrire des assertions.
@Test
@DisplayName("Le composant list du ticket détaille chaque règlement, troc compris")
void ticketDetailleLesPaiements() throws IOException {
    PdfLu ticket = lirePdf(imprimerie.imprimerTicket(commande("CMD-0042")));

    assertContient(ticket.texte(),
            "Règlement :",
            "Pièces d'or 40,00 po",
            "Troc : dent de wyverne 5,30 po");
}
Deux pièges à connaître.
Le premier : avec Locale.FRANCE, le séparateur de milliers n'est pas une espace classique mais une espace insécable fine (U+202F). "1 378,69" dans le PDF ne correspond donc pas à "1 378,69" tapé au clavier dans le test. La méthode lirePdf normalise ces caractères avant toute assertion.
Le second est plus vicieux : PDFBox lit aussi le texte qui déborde de son cadre. Pendant le développement, le libellé "TOTAL GÉNÉRAL (4 factures)" du relevé était trop large pour sa zone et s'affichait tronqué en "TOTAL GÉNÉRAL (4". Le test passait quand même, parce que le texte complet est bien présent dans le fichier. L'extraction de texte vérifie le contenu, pas la mise en page.
PDFBox sait pourtant lire bien plus que du texte, et quelques contrôles structurels comblent une partie du trou :
- La géométrie :
page.getMediaBox()donne les dimensions de chaque page. C'est ce qui prouve que le ticket fait 226 points de large et que sa hauteur suit le contenu. - La pagination :
setStartPage()etsetEndPage()extraient le texte page par page, de quoi vérifier un "Page 2 / 2" à la bonne place. - Les polices : on parcourt les ressources de chaque page et on vérifie que chaque
PDFontest embarquée (isEmbedded()) et appartient bien à la famille DejaVu.
Côté tableur, Apache POI (déjà fourni par l'extension) relit le classeur XLSX pour vérifier que les cellules contiennent les bonnes valeurs, au-delà de la simple signature PK d'une archive ZIP.
Reste la mise en page pure, qu'aucune assertion ne remplace vraiment. Le minimum est un coup d'œil systématique aux épreuves sur quelques documents représentatifs : un ticket court, un ticket long, une facture sur plusieurs pages et un relevé avec des libellés longs. L'étape suivante serait une comparaison d'images (le PDF rendu en PNG, comparé à une référence), mais c'est une autre histoire.
Pour la route
L'imprimerie de The Falling Whale tourne désormais à plein régime. Brunehilde tend un ticket à chaque client, le tavernier range des factures lisibles, et l'intendant reçoit son relevé mensuel, en PDF ou en tableur selon son humeur.
Côté technique, retenons quelques règles. On compile les plaques au build avec l'extension Quarkiverse. On garde les calculs en Java, dans des POJO à getters. On choisit le composant list pour les énumérations et le sous-rapport pour les blocs qui ont leur propre mise en page. On embarque ses polices. Et on relit ses épreuves.
Un dernier conseil en passant, vérifié avec la version 1.4.3 de l'extension : en mode dev, les .jrxml sont compilés au démarrage de Quarkus, mais une modification d'un rapport n'est pas détectée à chaud. Modifier le pied de page du ticket puis rappeler l'URL renvoie l'ancien texte, sans la moindre ligne de recompilation dans les logs, et le .jasper du dossier target ne bouge pas. Le rapport n'est recompilé que lorsque Quarkus redémarre pour une autre raison, par exemple après la modification d'une classe Java. L'extension ne recompile alors que les .jrxml plus récents que leur .jasper. Après une retouche de mise en page, il faut donc relancer quarkus:dev (ou toucher une classe Java), sinon l'application continue de servir l'ancienne version. Le comportement peut évoluer avec les versions de l'extension : en cas de doute, les logs de JasperReportsProcessor disent clairement ce qui a été compilé, et quand.
Et si l'imprimerie travaillait de nuit ?
Pour l'instant, chaque document est imprimé à la demande, quand un client ou l'intendant le réclame. Mais le relevé mensuel, lui, a tout d'un travail de fond : il ne concerne personne en particulier et pourrait être produit une fois pour toutes, chaque fin de mois.
Ça ressemble furieusement au travail du brasseur de la taverne nocturne. Un job batch qui génère les relevés de tous les fournisseurs pendant que la salle dort, les archive, et les envoie au petit matin à l'intendant par corbeau messager : de quoi faire tourner les presses une prochaine nuit.