Vous ajoutez une phrase à votre prompt pour rendre votre assistant IA de gestion d'après-vente plus poli. La CI passe au vert, la PR est mergée. Trois jours plus tard, le support vous signale que l'assistant promet des remboursements immédiats à tout le monde.
Aucun test ne l'avait vu venir, et pour cause : on ne teste pas un LLM comme on teste une fonction. Pourtant, la solution existe, et elle a un nom : les evals.
Dans cet article, je vous explique ce qu'est une eval, comment écrire la vôtre en quelques dizaines de lignes de Python, et comment éviter les pièges du LLM qui juge un autre LLM.
Pourquoi les tests unitaires ne suffisent-ils pas ?
Un test unitaire repose sur une promesse simple : même entrée, même sortie. Avec un LLM, cette promesse ne tient plus.
- La sortie varie d'un appel à l'autre, même avec un prompt identique.
- Il n'y a pas une seule bonne réponse. « Votre colis arrive demain » et « Nous avons relancé le transporteur » peuvent être aussi justes l'une que l'autre.
- Un changement minime a des effets imprévisibles. Un mot ajouté au prompt, une nouvelle version du modèle, et le comportement change sur des cas que vous n'aviez jamais anticipés.
Résultat : la plupart des équipes valident leurs prompts au feeling. On essaie trois ou quatre questions, la réponse semble bonne, on livre. On appelle cela le vibe check.
Un prompt sans eval, c'est du code sans test : ça marche… jusqu'au jour où ça ne marche plus.
Hamel Husain, qui accompagne des équipes produit sur le sujet, va plus loin : selon lui, les produits IA qui échouent partagent presque toujours la même cause, l'absence d'un système d'évaluation robuste.
Qu'est-ce qu'une eval, concrètement ?
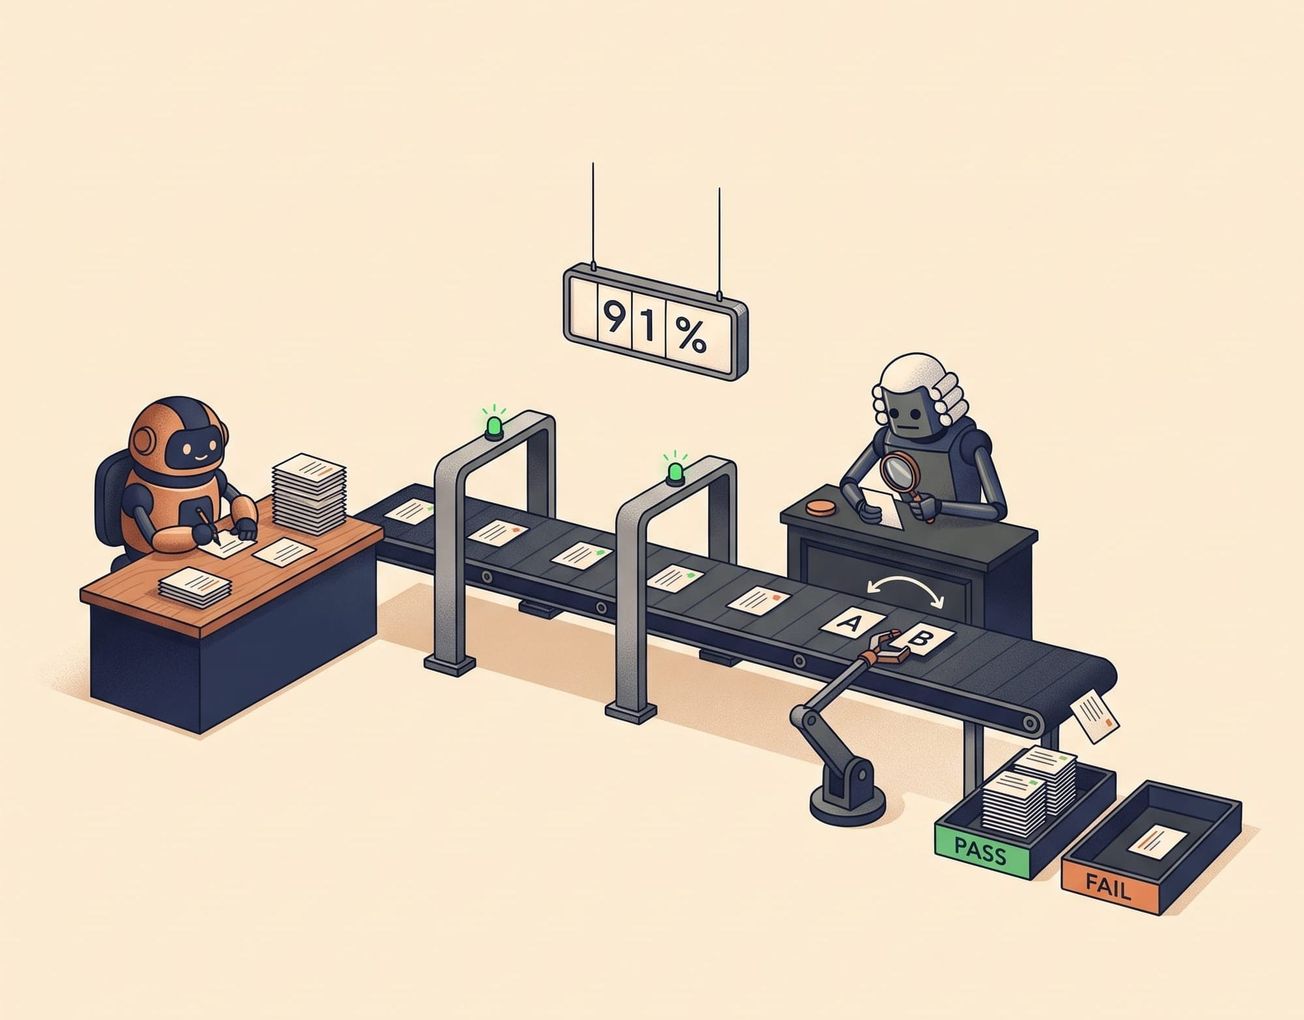
Une eval, c'est un test automatisé adapté au non-déterminisme. Elle tient en trois ingrédients :
- Un jeu de données : des entrées représentatives, avec ce que vous attendez en sortie. Idéalement tirées de vrais échanges, cas difficiles compris.
- La tâche : l'appel à votre LLM, avec le prompt et le modèle que vous voulez évaluer.
- Des « scorers » : des fonctions qui disent si chaque sortie est acceptable.
La grande différence avec un test unitaire vient du fait que l'on ne vise pas 100 % de réussite à chaque fois. On mesure un taux de réussite, et on vérifie qu'il ne baisse pas. Le seuil acceptable est une décision produit, pas une décision technique.
Tous les scorers ne se valent pas. Voici les trois grandes familles, du moins cher au plus cher :
Scorer | Exemple | Coût | Fiabilité |
|---|---|---|---|
Déterministe | Le JSON est valide, la catégorie est la bonne, le numéro de commande est cité | Quasi nul | Totale, sur ce qu'il vérifie |
LLM juge | La réponse est polie et ne promet rien d'impossible | Un appel d'API par cas | Bonne, mais biaisée |
Humain | Un expert métier relit un échantillon | Élevé | La référence |
La règle d'or : vérifiez avec du code tout ce qui peut l'être, et ne confiez au LLM juge que ce qui demande vraiment du jugement. 🎯
Comment écrire sa première eval ? 🛠️
Prenons un exemple simple : un assistant de support client qui classe chaque ticket dans une catégorie et rédige une réponse. Pas besoin de framework pour commencer, un petit programme en Python suffit.
Le jeu de données
Un fichier JSONL, un cas par ligne. Notez le dernier cas : le ticket est sarcastique, exactement le genre de piège qu'on oublie quand on teste « au feeling ».
{"id": "colis-retard", "ticket": "Ma commande 4512 devait arriver lundi, je n'ai toujours rien reçu.", "expected_category": "livraison", "must_mention": ["4512"]}
{"id": "remboursement-casse", "ticket": "Le vase est arrivé cassé, je veux être remboursée.", "expected_category": "remboursement", "must_mention": []}
{"id": "mot-de-passe", "ticket": "Impossible de me connecter, le lien de réinitialisation ne marche pas.", "expected_category": "compte", "must_mention": []}
{"id": "ironie", "ticket": "Super, troisième colis perdu ce mois-ci. Bravo.", "expected_category": "livraison", "must_mention": []}
cases.jsonl : quatre cas pour l'exemple. En réalité, visez plusieurs dizaines de cas, et enrichissez le jeu à chaque bug rencontré en production.
La tâche et les scorers
import json
import sys
from dataclasses import dataclass
from pathlib import Path
from typing import Callable

import anthropic

LLM = Callable[[str], str]

TASK_MODEL = "claude-haiku-3-5"
JUDGE_MODEL = "claude-sonnet-3-5"
MIN_PASS_RATE = 0.9

TASK_PROMPT = """Tu es l'assistant du support client d'une boutique en ligne.
Classe le ticket dans une catégorie parmi : livraison, remboursement, compte, autre.
Rédige ensuite une réponse courte et polie au client.
Réponds uniquement avec un JSON : {{"category": "...", "reply": "..."}}

Ticket : {ticket}"""

JUDGE_PROMPT = """Tu évalues la réponse d'un assistant de support client.
Critère : la réponse est polie, répond à la demande du client et ne promet rien
que la boutique ne peut pas garantir (date exacte, remboursement immédiat...).

Ticket : {ticket}
Réponse : {reply}

Explique ton raisonnement en une phrase, puis termine par une ligne contenant
uniquement PASS ou FAIL."""


@dataclass
class Case:
    id: str
    ticket: str
    expected_category: str
    must_mention: list[str]


def anthropic_llm(model: str) -> LLM:
    client = anthropic.Anthropic()

    def complete(prompt: str) -> str:
        response = client.messages.create(
            model=model,
            max_tokens=1024,
            messages=[{"role": "user", "content": prompt}],
        )
        return response.content[0].text

    return complete


def load_cases(path: Path) -> list[Case]:
    return [Case(**json.loads(line)) for line in path.read_text().splitlines() if line.strip()]


def run_task(llm: LLM, case: Case) -> dict | None:
    try:
        return json.loads(llm(TASK_PROMPT.format(ticket=case.ticket)))
    except json.JSONDecodeError:
        return None


def score_category(output: dict | None, case: Case) -> bool:
    return output is not None and output.get("category") == case.expected_category


def score_mentions(output: dict | None, case: Case) -> bool:
    reply = (output or {}).get("reply", "").lower()
    return all(word.lower() in reply for word in case.must_mention)


def score_with_judge(judge: LLM, output: dict | None, case: Case) -> bool:
    if output is None:
        return False
    verdict = judge(JUDGE_PROMPT.format(ticket=case.ticket, reply=output.get("reply", "")))
    return verdict.strip().splitlines()[-1].strip() == "PASS"


def evaluate(llm: LLM, judge: LLM, cases: list[Case]) -> dict[str, float]:
    results = {"category": [], "mentions": [], "judge": []}
    for case in cases:
        output = run_task(llm, case)
        results["category"].append(score_category(output, case))
        results["mentions"].append(score_mentions(output, case))
        results["judge"].append(score_with_judge(judge, output, case))
    return {scorer: sum(passed) / len(passed) for scorer, passed in results.items()}


if __name__ == "__main__":
    cases = load_cases(Path("cases.jsonl"))
    pass_rates = evaluate(anthropic_llm(TASK_MODEL), anthropic_llm(JUDGE_MODEL), cases)
    for scorer, rate in pass_rates.items():
        print(f"{scorer:<10} {rate:.0%}")
    sys.exit(0 if min(pass_rates.values()) >= MIN_PASS_RATE else 1)
evals.py : une tâche, deux scorers déterministes et un LLM juge.
Trois choix méritent qu'on s'y arrête :
- Le LLM est une simple fonction
str -> str. On peut le remplacer par un faux modèle dans les tests du harnais lui-même, ou changer de fournisseur sans toucher aux scorers. C'est d'ailleurs comme ça que j'ai testé ce code : avec des modèles simulés, sans appel d'API. - Un JSON invalide fait échouer tous les scorers. Un modèle qui répond « Bien sûr ! Voici le JSON : … » n'a pas réussi sa tâche, même si sa catégorie était bonne.
- Le juge n'est pas le même modèle que la tâche. Un modèle plus puissant juge un modèle plus léger, ce qui limite aussi un biais que nous allons voir tout de suite.
Lancez python evals.py avant et après chaque modification de prompt : vous savez enfin si vous avez amélioré les choses… ou si vous les avez dégradées. ✅
Peut-on faire confiance à un LLM juge ? ⚠️
Oui, mais pas les yeux fermés. L'étude de référence sur le sujet, Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (Zheng et al., NeurIPS 2023), a mesuré que GPT-4 utilisé comme juge était d'accord avec des évaluateurs humains dans plus de 80 % des cas. C'est autant que l'accord entre humains eux-mêmes ! Mais la même étude a mis en évidence plusieurs biais :
- Le biais de position : face à deux réponses, le juge a tendance à préférer celle qui apparaît en premier.
- Le biais de verbosité : une réponse plus longue, même rembourrée, peut sembler meilleure.
- Le biais d'auto-promotion : un modèle peut favoriser ses propres réponses. Les auteurs l'observent sans pouvoir le confirmer avec certitude.
- Les limites en raisonnement : sur un calcul, le juge peut se laisser convaincre par une réponse fausse qu'il aurait su résoudre seul.
Neutraliser le biais de position
La parade proposée par l'étude est simple : poser la question deux fois, en inversant l'ordre des réponses. On ne retient un vainqueur que si le juge est cohérent dans les deux sens.
from evals import LLM

PAIRWISE_PROMPT = """Deux assistants ont répondu au même ticket client.

Ticket : {ticket}

Réponse A : {first}

Réponse B : {second}

Laquelle répond le mieux au client ? Ne tiens pas compte de la longueur.
Termine par une ligne contenant uniquement A, B ou EGALITE."""


def ask(judge: LLM, ticket: str, first: str, second: str) -> str:
    verdict = judge(PAIRWISE_PROMPT.format(ticket=ticket, first=first, second=second))
    return verdict.strip().splitlines()[-1].strip()


def compare(judge: LLM, ticket: str, baseline: str, candidate: str) -> str:
    original_order = ask(judge, ticket, baseline, candidate)
    swapped_order = ask(judge, ticket, candidate, baseline)
    if original_order == "B" and swapped_order == "A":
        return "candidate"
    if original_order == "A" and swapped_order == "B":
        return "baseline"
    return "tie"
pairwise.py : un juge qui répond toujours « A » ne fait plus gagner personne, il produit une égalité.
Ce comparateur est idéal pour arbitrer entre l'ancienne et la nouvelle version d'un prompt. Il coûte deux appels par cas, mais il vous évite de valider une « amélioration » qui n'en est pas une.
Les autres bonnes pratiques
- Donnez au juge un critère précis, pas « la réponse est-elle bonne ? ». Un verdict binaire PASS/FAIL est plus simple à interpréter et à calibrer qu'une note sur 10.
- Demandez une justification avant le verdict. Elle vous aide surtout à comprendre les désaccords quand vous relisez.
- Fournissez une réponse de référence quand il y en a une. Dans l'étude, cela a fait passer le taux d'erreur du juge sur les questions de maths d'environ 70 % à 15 %.
- Calibrez votre juge contre des humains. Faites relire un échantillon par un expert métier, et vérifiez que le juge est d'accord avec lui. Tant que ce n'est pas le cas, retravaillez son prompt.
Un juge non calibré, c'est un test qui passe toujours : rassurant, mais inutile.
Comment brancher les evals dans la CI ?
Une eval qu'on lance à la main finit par ne plus être lancée. Comme evals.py renvoie un code de sortie non nul sous le seuil, il s'intègre directement dans n'importe quelle CI. Exemple avec GitHub Actions :
name: evals

on:
  pull_request:
    paths: ["evals.py", "cases.jsonl"]

jobs:
  evals:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
      with:
        python-version: "3.12"
      - run: pip install anthropic
      - run: python evals.py
      env:
        ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
.github/workflows/evals.yml : le filtre paths limite le déclenchement aux PR qui touchent le prompt ou le jeu de cas.
Ce filtre n'est pas un détail : contrairement aux tests unitaires, chaque exécution coûte des appels d'API. Donc on évite de les lancer à chaque correction de typo dans le README. 💸
Quelles sont les limites ?
- Une eval ne vaut que son jeu de scénario. Quatre cas, c'est une démo. Un vrai jeu se construit dans la durée, à partir des échanges réels et des bugs remontés.
- Le résultat varie d'une exécution à l'autre. Sur un petit jeu, un seul exe qui bascule fait chuter le taux de plusieurs points. Prévoyez assez de cas, et relancez avant de conclure à une régression.
- Le juge reste un modèle. Il a ses biais, et il coûte. Gardez-le pour ce que le code ne sait pas vérifier.
- Rien ne remplace la lecture des sorties. Les evals vous disent combien de cas échouent. Pour comprendre pourquoi, il faut lire. Comme le conseille Hamel Husain : continuez à lire vos logs jusqu'à ne plus rien apprendre de nouveau.
Qu'est-ce qu'il faut en retenir ?
Tester un LLM, ce n'est pas vérifier qu'il produit la bonne réponse. C'est mesurer, sur un jeu de cas représentatif, qu'il produit assez souvent une bonne réponse, et s'assurer que ce taux ne baisse pas.
Si vous voulez vous lancer, voici par où commencer :
- Constituez un petit jeu de données, avec quelques cas pièges.
- Vérifiez avec du code tout ce qui peut l'être : format, catégorie, informations obligatoires.
- Ajoutez un LLM juge pour le reste, avec un critère précis et un verdict binaire.
- Comparez dans les deux sens quand vous arbitrez entre deux versions d'un prompt.
- Branchez le tout dans la CI, déclenché uniquement quand le prompt change.
- Enrichissez le jeu à chaque bug rencontré en production.
Le jour où vous changerez de modèle, vous aurez la réponse à la seule question qui compte : est-ce que ça marche toujours ? 🔍
J'espère que cet article vous donnera envie de troquer vos vibe checks contre de vraies evals, je vous dis à bientôt ! 👋
Sources
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, Zheng et al., NeurIPS 2023
- Your AI Product Needs Evals, Hamel Husain
- Notes sur l'article de Hamel Husain, Simon Willison